요약
⏱ 00:001. 강의 개요
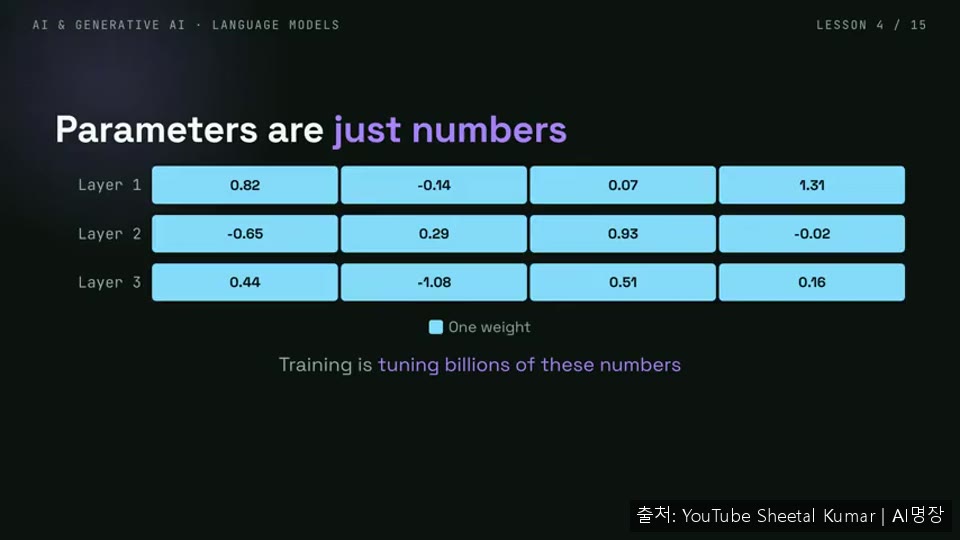
⏱ 00:00ChatGPT, Claude, Gemini 같은 챗봇은 모두 대규모 언어 모델(LLM)이라는 같은 종류의 엔진으로 동작합니다. LLM은 입력된 글을 읽고 글로 답하며, 이 강의는 엔진 내부가 어떻게 생겼는지, 왜 '대규모'라고 부르는지, 숫자 덩어리가 코드와 시를 쓰게 되는 원리를 다룹니다. 마지막에는 노트북에서 실제 모델을 직접 실행하는 것까지 목표로 합니다.
⏱ 00:562. LLM의 정의와 파라미터 규모
⏱ 00:56LLM은 다음에 올 텍스트 조각을 예측하도록 학습된 신경망입니다. '대규모'는 학습 데이터의 양, 내부 설정값인 파라미터의 개수, 계산 능력이 모두 크다는 뜻입니다. 파라미터는 네트워크 안의 조정 가능한 숫자이며, 2018년 초기 모델은 약 1억 개 수준이었고 2020년 GPT-3는 1750억 개였습니다. 요즘 많이 쓰이는 공개 모델은 대략 70억에서 700억 개 사이입니다.
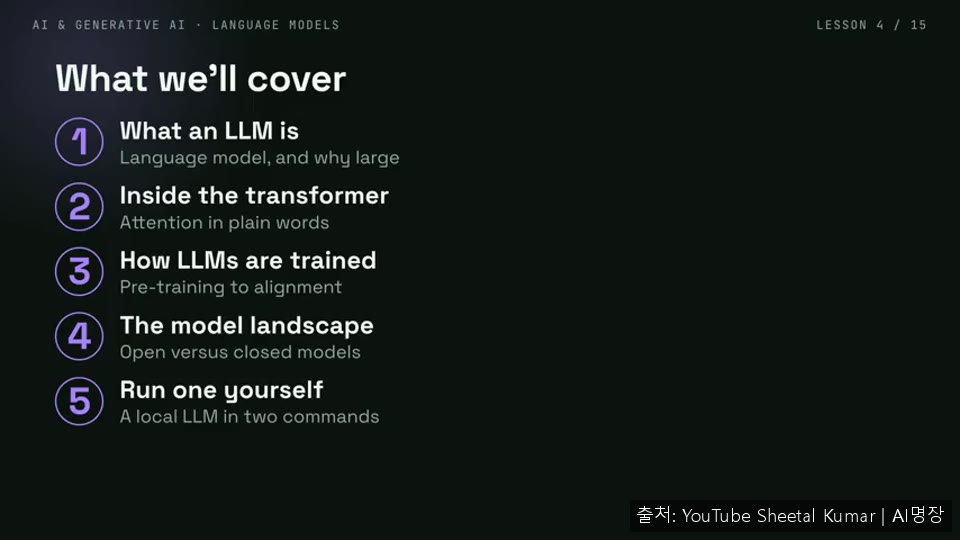
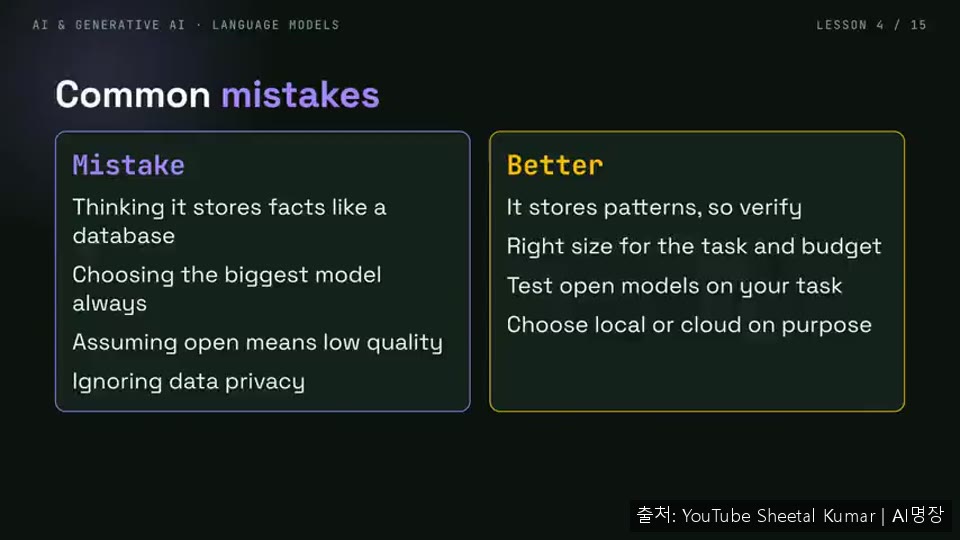
파라미터가 많으면 저장할 수 있는 패턴이 늘지만 비용도 커집니다. 잘 학습된 작은 모델이 엉성하게 학습된 큰 모델을 이길 수 있으므로, 데이터 품질도 크기만큼 중요합니다.
⏱ 02:513. 토큰과 트랜스포머 구조
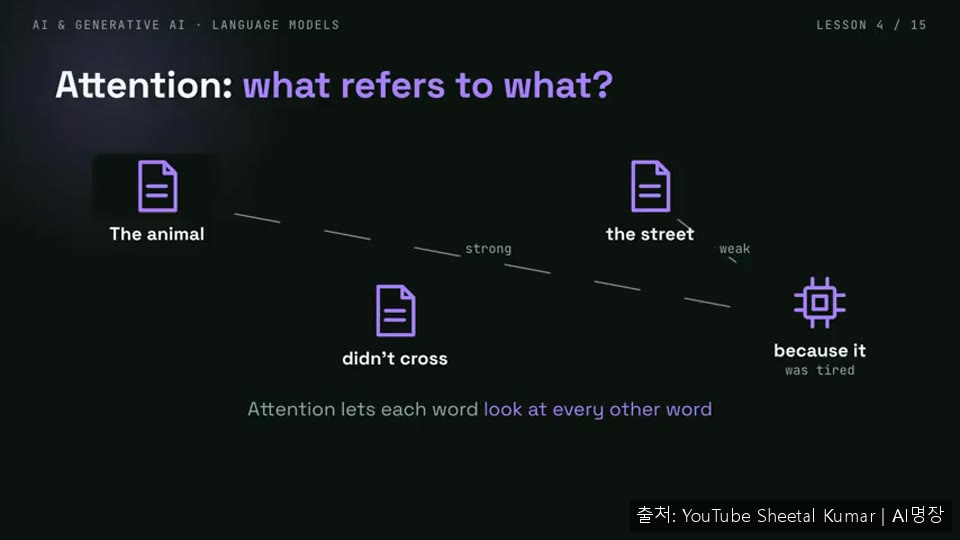
⏱ 02:51텍스트는 바로 모델에 들어가지 않습니다. 먼저 단어 또는 단어의 일부인 토큰으로 나뉘고, 각 토큰은 고정된 사전의 ID 번호를 받은 뒤 의미를 담은 벡터로 바뀝니다. 모델은 글자가 아니라 숫자만 다루기 때문에 철자 세기 같은 작업을 어려워하기도 합니다. 트랜스포머는 이 벡터에 단어 순서 정보를 더하고, 같은 구조의 블록을 수십 층 쌓아 올립니다. 각 블록에는 어텐션 단계와 순전파 단계가 있습니다.
⏱ 04:414. 학습 단계와 비용
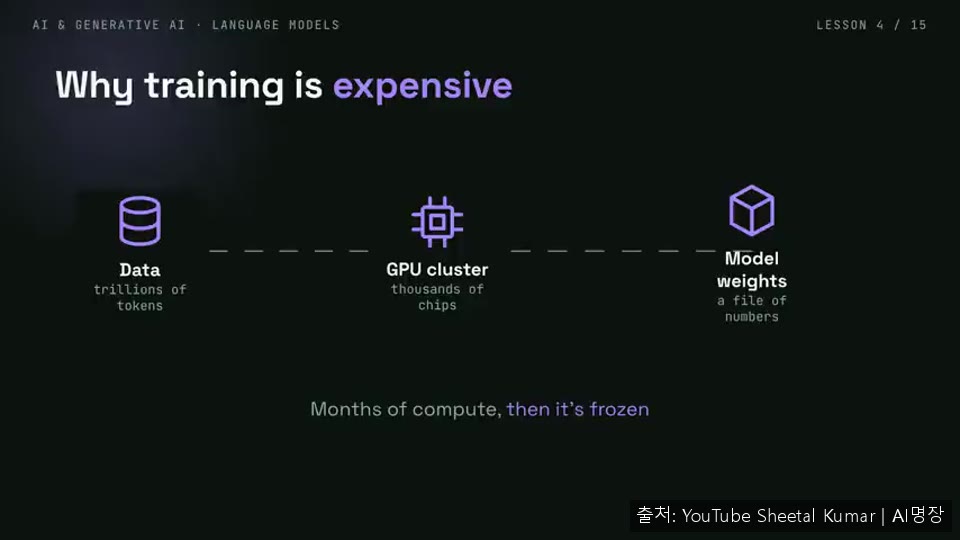
⏱ 04:41학습은 여러 단계로 진행됩니다. 1단계 사전 학습에서는 책, 웹사이트, 코드에서 수조 개의 토큰을 읽으며 다음 토큰 맞추기를 반복합니다. 이 단계의 모델은 뛰어난 자동완성기에 가깝고 아직 도움을 주는 조수는 아닙니다. 2단계 지시 튜닝에서는 질문과 좋은 답변 예시를 보여 주고, 3단계 사람 피드백에서는 사람이 답변 순위를 매겨 선호를 학습시킵니다. 4단계는 출시 전 안전성 테스트입니다. 사전 학습은 지식을, 튜닝과 피드백은 대화 예절을 준다고 정리할 수 있습니다.
⏱ 05:565. 클로즈드와 오픈 모델, 로컬과 클라우드
⏱ 05:56클로즈드 모델(Claude, GPT, Gemini)은 API로만 쓸 수 있고 보통 품질이 가장 높으며 사용량만큼 지불합니다. 대신 프롬프트가 제공자 서버로 전송됩니다. 오픈 웨이트 모델(Llama, Mistral, Qwen 등)은 직접 내려받아 실행할 수 있고 라이선스 비용이 없으며, 비용은 하드웨어로 치르고 데이터는 내 기기에 남습니다. 어느 쪽이 항상 낫다고 할 수는 없고 품질, 비용, 개인정보 요구에 따라 고르면 됩니다. 흔한 방식은 클로즈드 모델로 프로토타입을 만든 뒤 더 저렴한 오픈 모델이 충분한지 시험해 보는 것입니다.
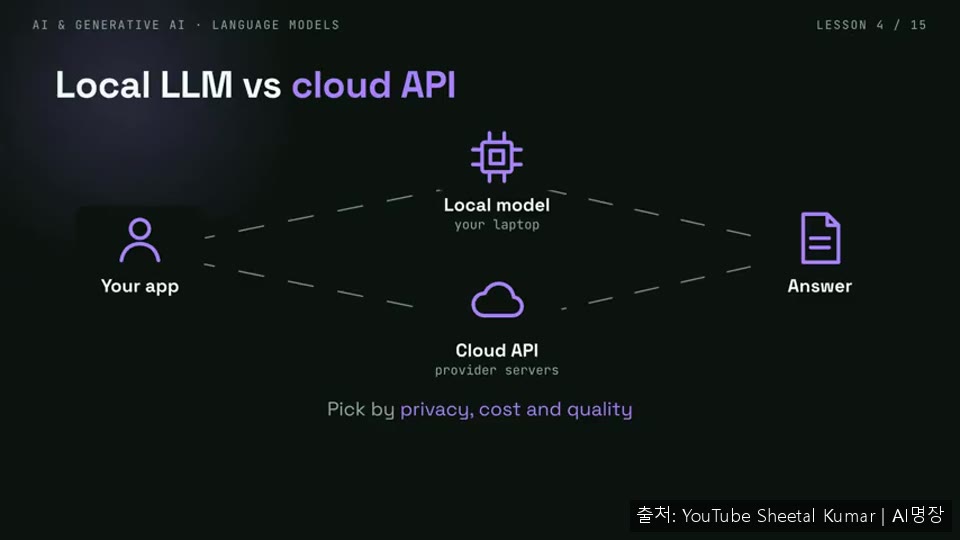
앱이 LLM을 호출하는 방법도 두 가지입니다. 로컬 모델은 요청이 노트북을 벗어나지 않아 요청당 비용이 없지만, 하드웨어가 모델 크기와 속도를 제한합니다. 클라우드 API는 인터넷을 거쳐 강력한 서버에 요청하며, 보통 가장 성능이 좋고 사용자 쪽 장비가 필요 없습니다.
⏱ 07:096. 로컬 실행 방법과 LLM의 한계
⏱ 07:09노트북에서 실행하려면 무료 앱인 Ollama를 설치합니다. 모델을 pull하면 가중치 파일이 내려받아지며, 작은 모델은 몇 기가바이트 수준입니다. 다운로드 이후에는 인터넷 없이 대화창에서 답변이 토큰 단위로 나타납니다. 코드에서 호출할 때는 노트북의 localhost 11434 포트에서 도는 작은 웹 서버에 모델 이름과 프롬프트를 담아 요청합니다. stream을 false로 두면 토큰마다 받는 대신 완성된 답을 한 번에 받습니다. 모델 이름만 바꾸면 두뇌를 바꾸는 것이므로 이 패턴은 어떤 모델에도 똑같이 쓸 수 있습니다.
LLM의 한계도 알아야 합니다. 첫째, 실시간 지식이 없어 학습 시점 이후의 뉴스를 모릅니다. 둘째, 환각을 일으켜 틀린 내용을 확신하는 말투로 말할 수 있습니다. 셋째, 문맥 창에 들어가는 만큼만 보므로 기억이 제한적입니다. 넷째, 스스로 행동하지 못해 텍스트만 만들고 이메일 발송이나 코드 실행은 하지 못합니다. 이후 강의의 검색, 도구 사용, 에이전트 기법은 이 한계를 보완하는 장치입니다.
⏱ 09:287. 정리와 과제
⏱ 09:28정리하면 LLM은 다음 토큰을 예측하는 거대한 신경망이고, 트랜스포머의 어텐션이 여러 층에 걸쳐 문맥을 이해하게 합니다. 학습은 사전 학습, 지시 튜닝, 사람 피드백의 단계로 이루어지며, 품질·비용·개인정보를 고려해 오픈 또는 클로즈드, 로컬 또는 클라우드를 고르면 됩니다.
과제는 Ollama로 작은 모델을 받아 같은 질문을 클라우드 챗봇과 비교해 보고, 직접 만든 프롬프트로 로컬 스크립트를 실행해 보며, 로컬과 클라우드에 각각 더 맞는 작업 두 가지씩을 이유와 함께 적는 것입니다. 다음 강의에서는 메시지 하나가 입력부터 답변까지 거치는 과정을 따라갑니다.