요약
⏱ 00:001. 단어를 숫자로 바꾸기
⏱ 00:00강의는 단어를 의미가 살아 있는 숫자로 바꾸는 방법을 따라간다. 가장 단순한 방법은 가방 모델(bag of words)로, 문장을 토큰으로 나눈 뒤 전체 어휘를 모아 각 단어가 몇 번 나오는지 세어 벡터를 만든다. 공백 기준 분리는 띄어쓰기가 없는 중국어 같은 언어에는 맞지 않아 더 똑똑한 토큰화가 필요하다고 짚는다.
하지만 가방 모델은 단어의 순서와 뜻을 무시해 '개가 사람을 문다'와 '사람이 개를 문다'를 같은 것으로 취급한다는 한계가 있다.
⏱ 01:122. 워드투벡과 임베딩
⏱ 01:12의미를 담으려는 첫 시도로 2013년 워드투벡이 등장했다. 임베딩은 어떤 대상의 의미를 담으려는 벡터이며, 신경망이 단어 쌍이 이웃 관계인지 맞히도록 학습하면서 가중치(파라미터)를 조정한다. 처음에는 모든 단어가 무작위 벡터를 가지지만, 학습이 반복되면서 이웃을 공유하는 단어끼리 가까워진다.
각 차원이 사람이 이해하는 개념과 딱 맞아떨어지지는 않아도, 비슷한 단어가 비슷한 숫자를 가지므로 거리를 재어 과일끼리, 동물끼리 묶이는 군집을 확인할 수 있다. 임베딩은 단어, 문장, 문서 단위로도 만들 수 있다.
⏱ 03:223. 문맥 문제와 어텐션
⏱ 03:22워드투벡의 문제는 단어마다 고정된 벡터를 하나만 준다는 점이다. 강가의 bank와 은행의 bank는 뜻이 다르므로 임베딩이 문맥에 따라 달라져야 한다. 이를 위해 순환신경망(RNN)이 문장을 한 단어씩 읽는 방식이 쓰였다. 인코더가 입력을 읽고 디코더가 출력을 한 단어씩 만들었지만, 인코더가 전체 문장을 하나의 문맥 벡터로 압축하므로 긴 문장에서는 병목이 생겼다.
⏱ 04:464. 트랜스포머의 등장
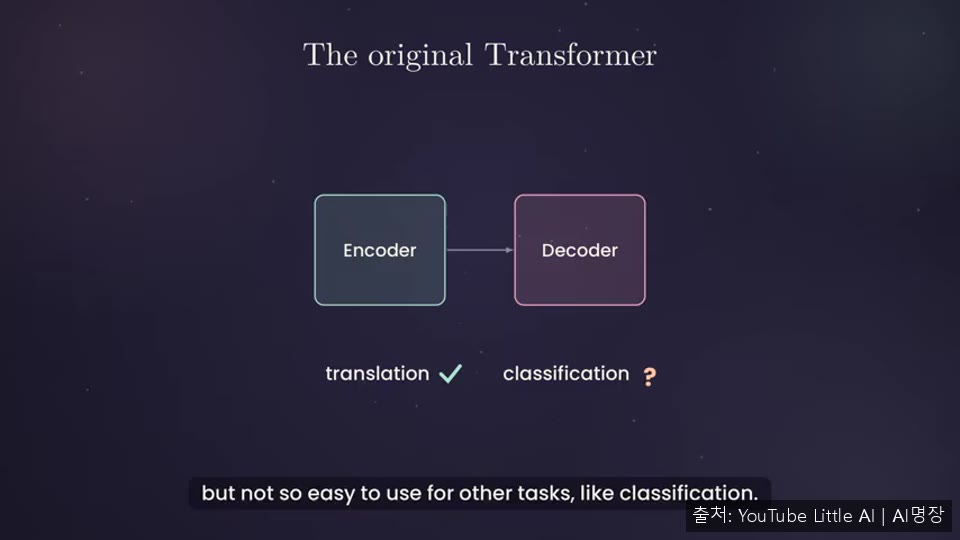
⏱ 04:462017년 논문 'Attention is all you need'는 순환 구조 없이 어텐션만으로 만든 트랜스포머를 제시했다. 순서대로 처리하지 않으니 학습을 병렬로 돌려 훨씬 빠르게 훈련할 수 있었다. 인코더 블록은 셀프 어텐션과 피드포워드 신경망으로 이루어지고, 셀프 어텐션은 같은 문장 안의 모든 단어가 서로를 앞뒤 가리지 않고 참조하게 한다.
⏱ 05:445. BERT와 GPT의 분화
⏱ 05:442018년 BERT는 인코더만 남기고 디코더를 버렸다. 문장 맨 앞의 CLS 토큰 임베딩이 입력 전체를 대표하도록 하고, 일부 단어를 가린 뒤 맞히게 하는 마스크드 언어 모델링으로 학습했다. 대규모 텍스트로 미리 학습한 뒤 작은 과제에 맞춰 미세조정하는 전이 학습 방식이다. 강좌는 이런 인코더 전용 모델을 표현 모델이라 부른다.
같은 해 디코더 쪽에서는 GPT가 등장했다. GPT-1은 약 1.17억 개 파라미터였고, GPT-2는 15억, GPT-3는 1750억 개로 빠르게 커졌다.
⏱ 06:576. 생성형 LLM과 두 단계 학습
⏱ 06:57생성형 LLM은 본질적으로 자동완성 기계다. 주어진 텍스트를 이어 쓰며, 지시를 따르도록 미세조정하면 질문에 답하는 챗 모델이 된다. 문맥 길이, 즉 한 번에 처리할 수 있는 토큰 수에는 한계가 있고, 생성한 토큰도 이 창을 차지한다. ChatGPT는 GPT-3.5, 이후 GPT-4 같은 모델 위에서 돌아가는 제품이며, Mamba나 RWKV처럼 트랜스포머에 도전하는 구조도 나왔다.
LLM의 기준은 상대적이라 강좌는 분류만 하는 모델도 포함한다. 학습은 보통 두 단계다. 먼저 인터넷 텍스트에서 다음 단어를 예측하는 사전 학습으로 기반 모델을 만들고, 이후 지시 따르기나 분류 같은 좁은 과제로 추가 학습(미세조정)을 한다. 사전 학습은 막대한 연산이 들지만 미세조정은 개인도 감당할 수 있는 수준이라는 점이 강조된다.
⏱ 09:477. 활용, 책임, 실행 환경
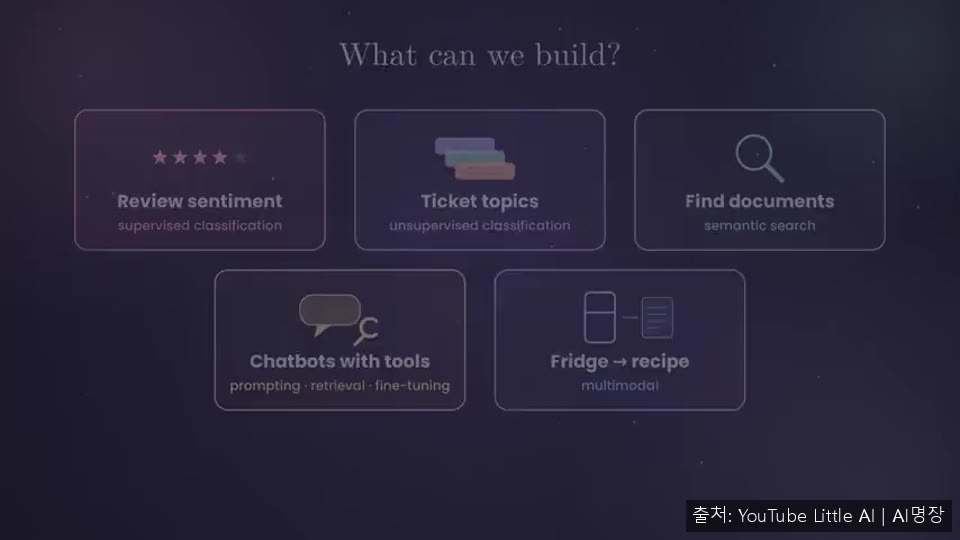
⏱ 09:47LLM으로 할 수 있는 일은 리뷰 감성 분류, 라벨 없는 문서의 주제 찾기, 의미 기반 검색, 도구와 문서를 쓰는 챗봇, 사진으로 레시피를 추천하는 멀티모달 작업 등이다. 편향, 투명성, 잘못된 정보와 악용, 저작권, 규제 같은 책임 문제도 함께 짚는다. 실행에는 주로 GPU 메모리(VRAM)가 필요하고, 대형 모델 학습 비용은 매우 크다.
모델 사용은 두 방식으로 나뉜다. 비공개 가중치 모델은 API로 쓰며 성능이 강하지만 비용과 데이터 제공 문제가 있고 직접 미세조정할 수 없다. 공개 모델은 직접 내려받아 제어권과 데이터 보안을 얻지만 적절한 하드웨어와 지식이 필요하다. 마지막으로 강좌는 Phi-3 mini를 로드해 농담을 생성하는 첫 실습을 보여 주며 토큰화기와 파이프라인 사용법을 짚고, 다음 시간에는 토큰과 임베딩을 더 자세히 다룬다고 예고한다.