요약
⏱ 00:001. 강의 개요와 동기
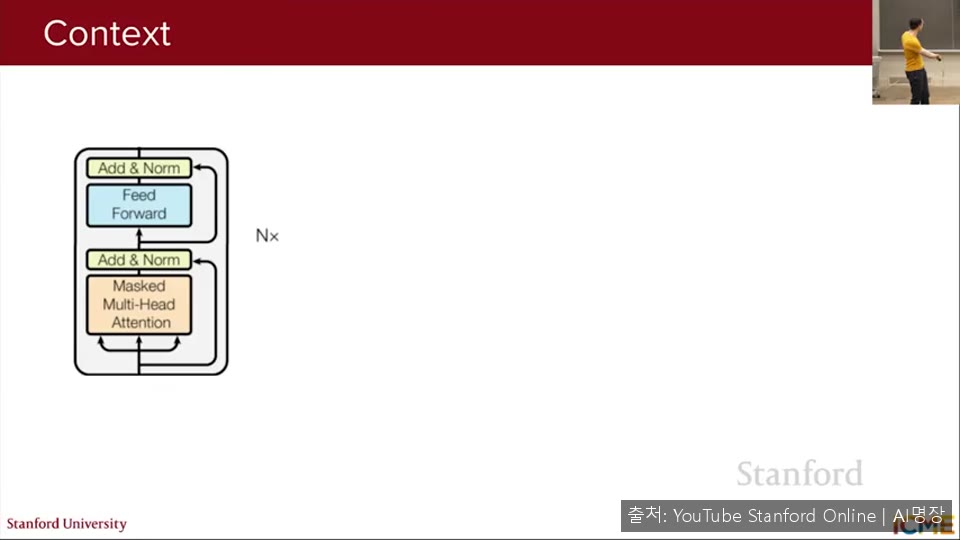
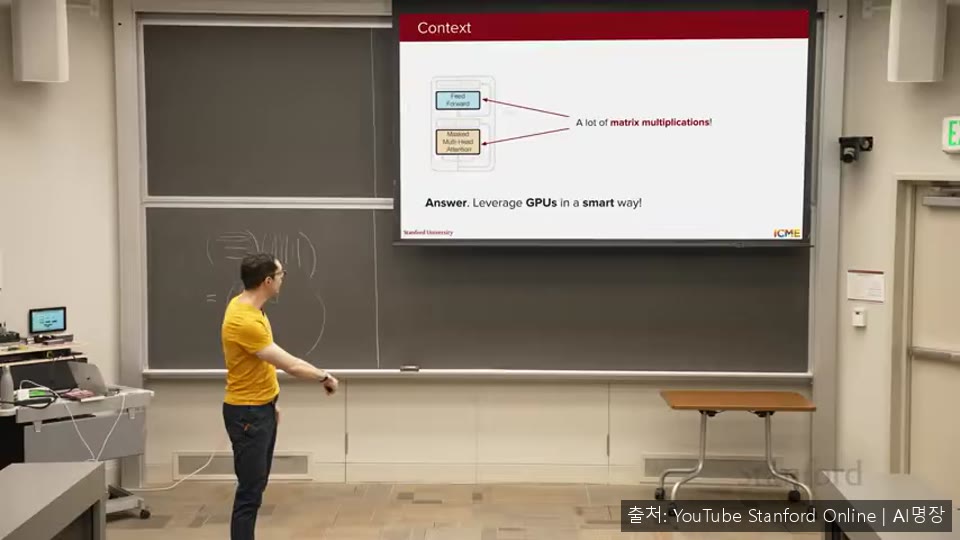
⏱ 00:00이번 강의는 대규모 언어 모델을 실제로 학습하고 서비스하기 위해 필요한 시스템 측면을 다룹니다. LLM은 트랜스포머 디코더를 가져와 파라미터 규모를 키운 모델이며, 수조 개 토큰으로 사전 학습하는 비용 때문에 막대한 하드웨어와 인프라가 필요하다고 짚습니다. 핵심 질문은 이론을 실제로 어떻게 구현해 돌아가게 만드냐는 것입니다.
⏱ 02:042. 디코더 구조와 GPU의 역할
⏱ 04:063. GPU 사양과 메모리 제약
⏱ 04:06강사는 연산량을 나타내는 FLOPs(소문자 s)와 하드웨어 연산 속도를 나타내는 FLOPS(대문자 S, 초당 연산 횟수)를 구분합니다. 엔비디아 H200 데이터시트를 예로 들며 메모리가 141GB 수준임을 보여줍니다.
⏱ 09:274. 어텐션의 메모리 병목과 HBM·SRAM
⏱ 09:27셀프 어텐션은 쿼리와 키의 곱으로 시퀀스 길이 N에 대한 N×N 행렬을 만들며, 토큰이 천 개만 되어도 백만 개 항목을 다뤄야 합니다. 이 행렬은 저장 비용도 커서 문제가 됩니다.
GPU에는 칩 외부의 HBM과 칩 내부의 SRAM이 있습니다. HBM은 용량이 크지만 초당 약 1TB 수준으로 상대적으로 느리고, SRAM은 훨씬 빠르지만 용량이 매우 작습니다. 소프트맥스가 행 전체의 합을 필요로 하기 때문에, 단순한 구현은 중간 행렬을 HBM에 쓰고 다시 읽는 과정을 여러 번 거치게 됩니다. 강의의 목표는 이 읽기와 쓰기 횟수를 줄이는 것입니다.
⏱ 17:175. 소프트맥스의 반복 계산 아이디어
⏱ 17:17플래시 어텐션은 전체 행을 한꺼번에 처리하지 않고 반복적으로 계산해 HBM 접근을 줄이는 방법을 목표로 합니다. 결과는 근사가 아니라 정확한 값입니다.
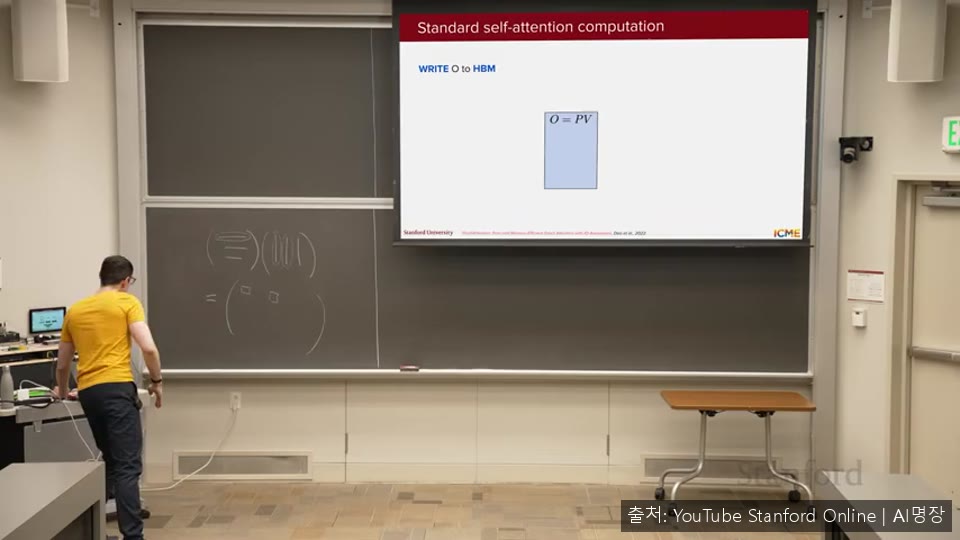
강사는 소프트맥스 결과를 분자(지수와 값의 가중합)와 분모(지수의 합)로 나누어 보면, 두 양 모두 원소를 하나씩 더해가며 갱신할 수 있다고 설명합니다. 새 원소가 들어올 때마다 이전 누적값을 조정하면 최종 결과를 얻을 수 있습니다. 칠판에서 세 개 원소를 예로 들어 단계별로 보여줍니다.
⏱ 27:176. 수치 안정성과 최대값 추적
⏱ 27:17지수 함수는 값이 커지면 수치적으로 불안정해지므로, 분자와 분모에 같은 상수를 곱해도 비율이 변하지 않는 성질을 이용합니다. 지금까지 본 원소들의 최대값을 계속 추적하고, 그 값을 기준으로 지수를 취해 계산하면 큰 값이 만들어지지 않습니다.
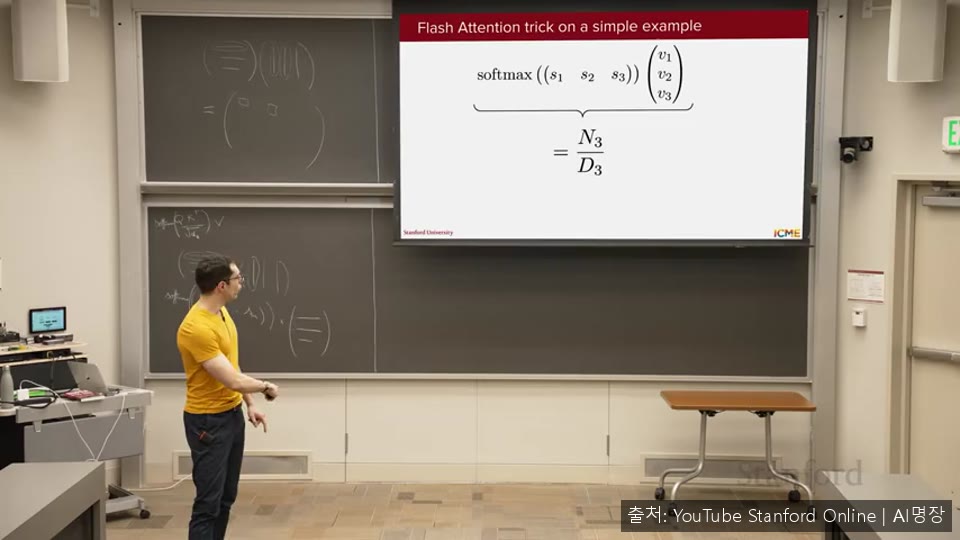
두 번째 반복에서 최대값이 바뀌면 이전까지 누적한 값들도 새 상수로 다시 스케일링해야 합니다. 강사는 지수가 매우 작아져 0에 가까워지는 경우에도 원래 작은 기여가 무시될 뿐이므로 큰 문제가 아니라고 정리합니다.