요약
⏱ 04:331. 강의 소개와 전체 로드맵
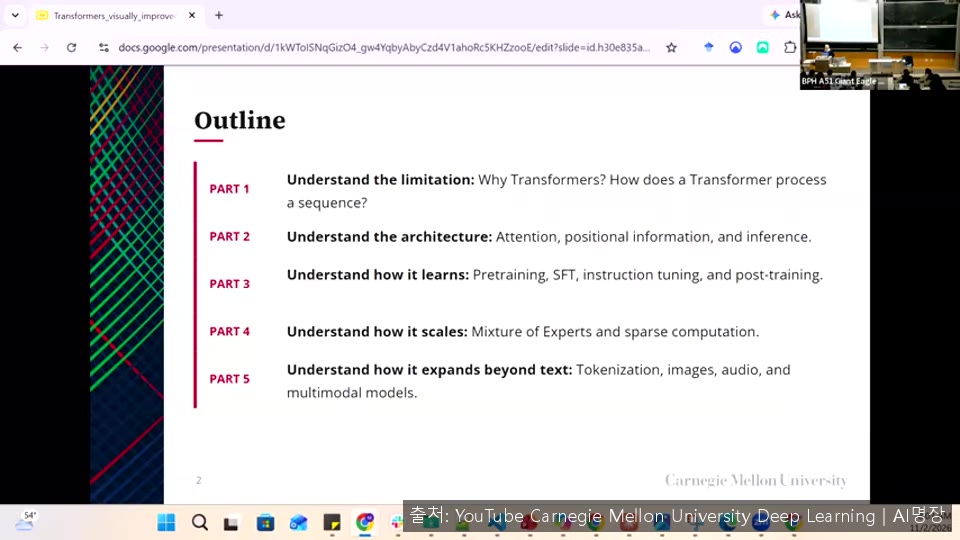
⏱ 04:33강의는 ChatGPT, Gemini, Whisper 같은 최근 모델과 이미지 검색용 비전 모델이 공통으로 쓰는 트랜스포머를 다룬다고 소개합니다. 전체 강의는 다섯 부로 나뉘며, 기존 모델의 한계, 트랜스포머의 작동 원리, 사전 학습과 사후 학습, 전문가 혼합을 통한 확장, 텍스트 밖의 여러 양식으로의 확장을 차례로 다룹니다.
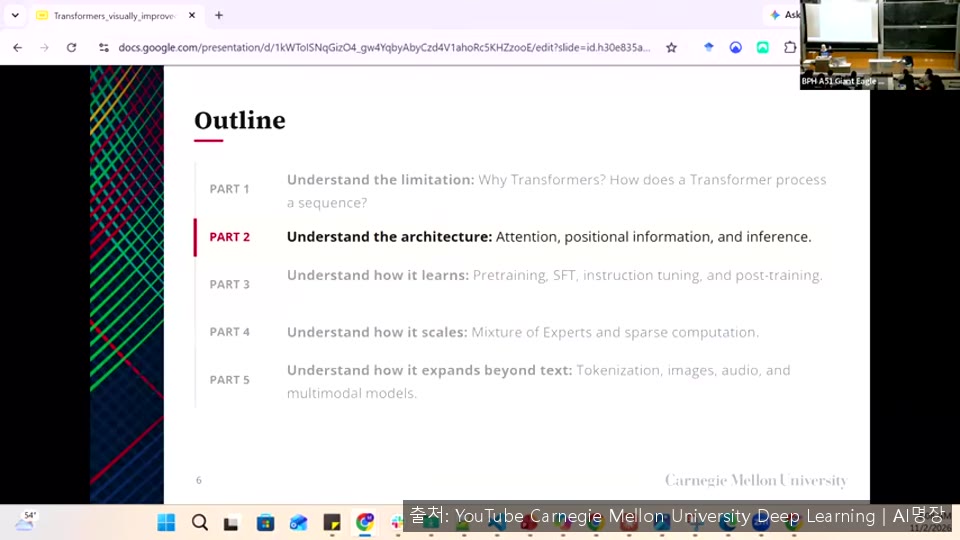
강사는 이 가운데 트랜스포머의 작동 원리를 설명하는 2부가 가장 큰 비중을 차지한다고 밝힙니다.
⏱ 06:432. 트랜스포머가 필요했던 이유
⏱ 06:43'bank'처럼 같은 단어도 주변 문맥에 따라 금융 기관이나 강둑으로 의미가 달라집니다. 단어마다 고정된 벡터를 쓰는 임베딩은 여러 의미와 문맥 정보를 한 벡터에 뒤섞기 때문에 한계가 있습니다. 그래서 주변 단어까지 반영한 문맥적 임베딩이 필요하며, 이를 가능하게 하는 것이 셀프 어텐션입니다.
⏱ 11:483. 트랜스포머의 전체 구조
⏱ 11:48원래 트랜스포머는 입력을 이해하는 인코더와 출력을 생성하는 디코더로 구성됩니다. 핵심 부품은 토큰끼리 정보를 주고받는 어텐션, 각 토큰을 독립적으로 처리하는 피드포워드 네트워크, 학습을 안정시키는 잔차 연결과 정규화, 순서 정보를 주는 위치 인코딩입니다. 강사는 어텐션을 통신, 피드포워드 네트워크를 계산으로 비유하여 기억하라고 권합니다.
⏱ 17:314. 쿼리, 키, 밸류와 어텐션 수식
⏱ 17:31어텐션은 두 벡터의 내적으로 관련성을 구하고, 소프트맥스로 합이 1인 가중치를 만든 뒤 가중 평균을 취합니다. 다만 같은 벡터로 유사성과 관련성을 모두 판단하면 한계가 있으므로, 각 토큰에 쿼리, 키, 밸류라는 세 개의 학습된 표현을 부여합니다. 쿼리는 무엇을 찾는지, 키는 어떤 정보를 가졌는지, 밸류는 실제로 전달할 내용을 뜻하며 도서관에 비유할 수 있습니다.
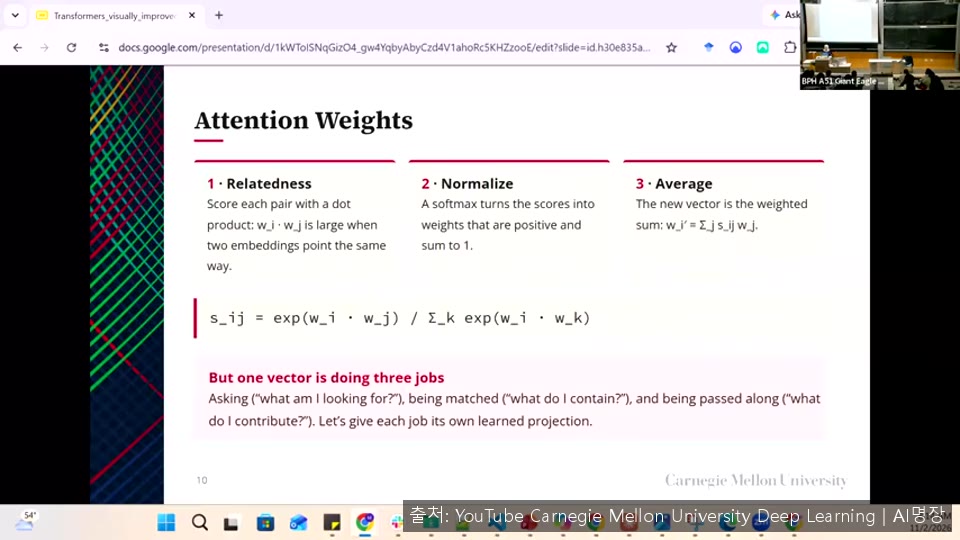
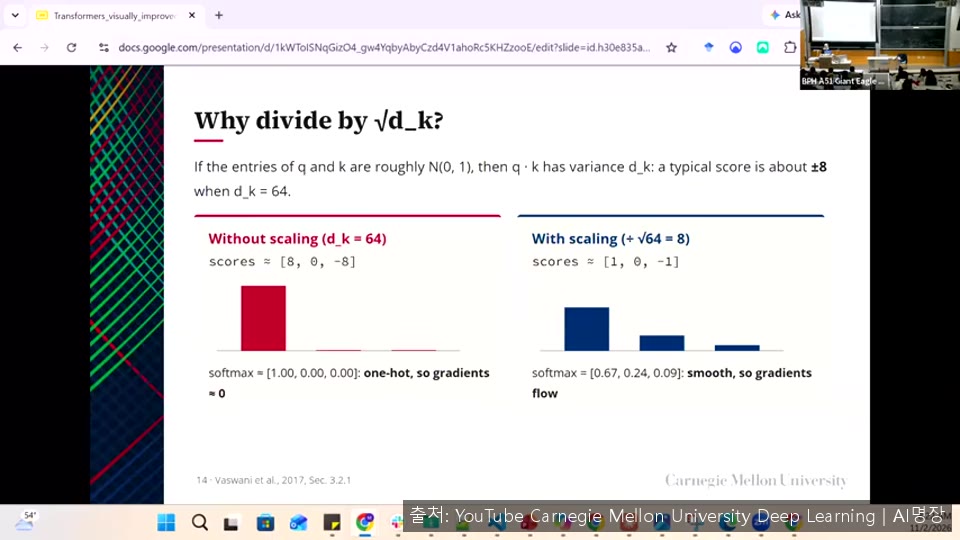
수식은 쿼리와 키의 전치 행렬을 곱하고, 키 차원의 제곱근으로 나눈 뒤, 소프트맥스를 적용하고, 밸류를 곱하는 네 단계입니다. 강사는 작은 숫자로 'sat'의 어텐션을 손으로 계산해 보입니다. 차원 제곱근으로 나누는 이유는 차원이 커질수록 내적 값이 지나치게 커져 소프트맥스가 한 곳에 몰리고 그래디언트가 약해지는 것을 막기 위해서입니다. 또한 모든 토큰 쌍을 비교하므로 시퀀스 길이에 대해 이차 복잡도를 가진다는 점도 짚습니다.
⏱ 25:335. 피드포워드, 잔차 연결, 위치 인코딩과 마스킹
⏱ 25:33어텐션으로 정보를 모은 뒤에는 피드포워드 네트워크가 각 토큰을 독립적으로 처리합니다. 차원을 넓혔다가 비선형 함수를 거쳐 다시 줄이는 2층 구조이며, 매개변수의 큰 부분을 차지하므로 나중에 전문가 혼합에서 다시 다룬다고 예고합니다. 잔차 연결은 입력을 출력에 더해 깊은 모델의 학습을 돕고, 레이어 정규화는 활성화 값을 안정시킵니다.
어텐션은 순서를 알지 못하므로 위치 인코딩이 필요합니다. 디코더에서는 미래 토큰을 보지 못하도록 인과적 마스킹을 적용해 대각선 위를 음의 무한대로 채우고, 학습 중에는 이 덕분에 모든 위치를 병렬로 처리합니다. 실제 생성 단계에서는 한 번에 하나의 토큰만 만든다는 점으로 이번 구간을 정리합니다.