
요약
⏱ 00:001. 도입: 가중치를 직접 프로그래밍한다는 발상
⏱ 00:00신경망의 원시 부동소수점 가중치를 자연어로 직접 편집해 LLM의 사고 방식을 바꿀 수 있을까? 영상은 이 질문으로 시작하며, 이를 '가중치 공간 프로그래밍(Weight-Space Programming)'이라 부르고 2026년 11월 2일 발표된 MIT CSAIL 논문을 소개한다.
⏱ 02:022. 기존 LLM 최적화의 경계
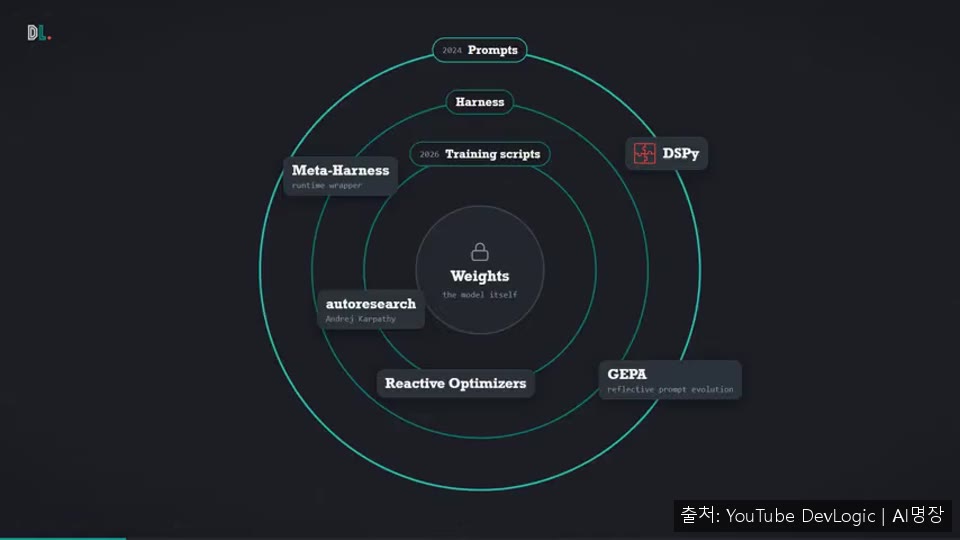
⏱ 02:02지난 몇 년간 LLM은 주로 모델 주변의 텍스트 산출물, 즉 프롬프트를 최적화하는 데 쓰였다. DSPy와 GEPA는 반성적 프롬프트 진화가 강화학습보다 나을 수 있음을 보였고, Meta-Harness는 모델을 감싸는 실행 래퍼 전체를 최적화했다. 이후 Karpathy의 autoresearch 등은 학습 스크립트와 하이퍼파라미터 스케줄까지 다시 쓰는 단계로 나아갔다.
⏱ 02:593. 가중치를 읽는 능력 검증
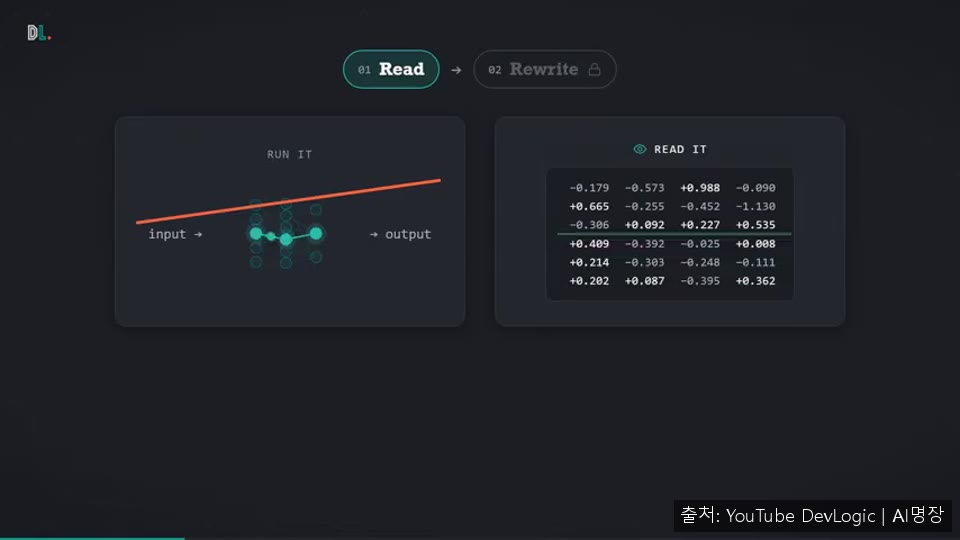
⏱ 02:59먼저 LLM이 가중치를 실제로 읽을 수 있는지 확인하는 실험이 소개된다. 실험 1에서는 PPO로 학습한 네 가지 강화학습 정책(Breakout, Pong, Pac-Man, Freeway)을 같은 구조의 다층 퍼셉트론으로 만들고, 가중치를 텍스트로 제공했다. 구조만으로 게임을 알 수 없도록 설계했고, 코드 실행과 선택지 제공도 금지했다. 모델은 네 게임을 모두 맞혔다. 예를 들어 Breakout 네트워크에서는 바닥 근처 행의 큰 가중치를 수평으로만 움직이는 패들로 읽고, 상단 행의 구조를 벽돌 배열로 해석했다고 한다.
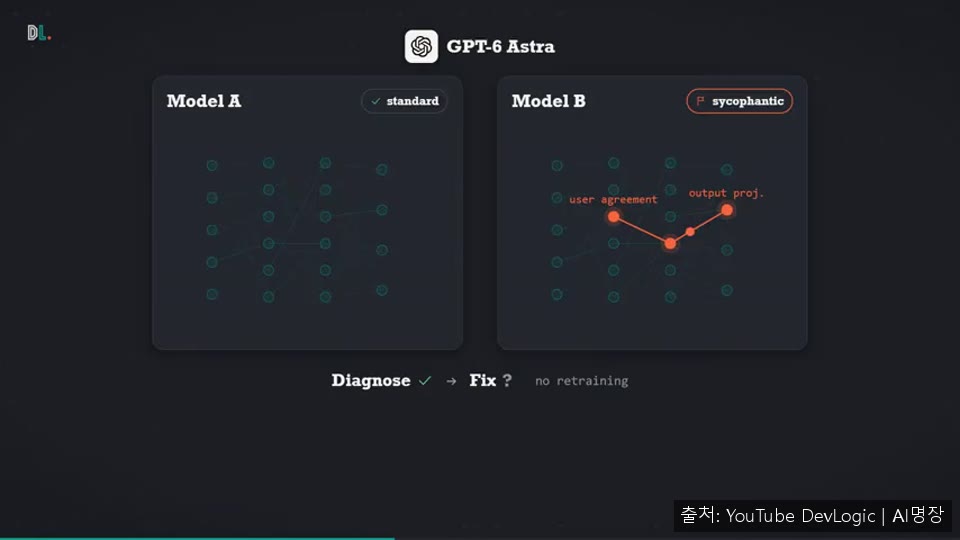
실험 2와 3에서는 원, 삼각형, 사각형을 생성하는 확산 모델과 서로 다른 언어로 학습된 소형 트랜스포머에 같은 방식을 적용했다. 실험 7에서는 아첨하도록 학습된 모델을 표준 모델과 비교해, 행동 테스트 없이 가중치 구조만으로 식별했다. 영상은 이를 행동 기반 감사에서 정적 가중치 분석으로 바뀌는 신호로 해석한다.
⏱ 06:224. 가중치 수정과 처음부터 작성
⏱ 06:22다음 단계는 읽기를 넘어 고치기다. 실험 4에서는 자동차가 가파른 경사를 넘지 못해 성공률이 0%인 제어 정책을 다뤘다. 보통이라면 보상 함수를 재설계하고 긴 재학습을 해야 하지만, 연구진은 실패 사양을 자연어로 설명하고 가중치를 모델에 넘겼다. 모델은 추력이 경계를 넘지 못하게 막던 상태-행동 매핑의 죽은 영역을 찾아 가중치의 3.5%만 한 번에 수정했고, 수정된 정책의 성공률은 100%가 되었다. 환경 시뮬레이션이나 그래디언트 업데이트 없이 이루어졌다는 점이 강조된다.
실험 5와 6은 더 과감하다. 게임 규칙만 보고 MinAtar 게임용 신경망을 피드백 없이 처음부터 설계하게 했는데, 결과물이 PPO로 1억 스텝 학습한 네트워크를 능가했다고 한다. 바둑 실험에서는 대칭성, 활로 계산, 따냄 위협 같은 휴리스틱을 합성곱과 완전연결 층의 가중치에 직접 인코딩했다고 설명된다.
⏱ 09:395. 실험 8: Qwen3.5 수학 추론 개선
⏱ 09:39영상의 핵심인 실험 8의 대상은 800M 파라미터의 오픈 가중치 모델 Qwen3.5다. 이 소형 추론 모델은 다단계 문제에서 같은 추론 문구를 반복하다 토큰 한계에 도달하는 문제를 안고 있으며, Qwen의 모델 카드도 이 경향을 경고한다. 표준 샘플링에서 MATH-500 정확도는 7.9%에 그친다. 추론 시 반복 패널티는 수학 정밀도를 떨어뜨리고, 합성 데이터 기반 지도 미세조정이나 RLHF는 치명적 망각과 높은 비용이라는 부담이 있다.
연구진은 Astra에게 격리된 환경에서 Qwen3.5의 가중치 접근 권한만 주고 수학을 더 잘하게 만들라는 과제를 냈다. 경사 하강법과 학습 루프는 금지했다. 모델은 층별 노름, 특이값, 어텐션 헤드 결합, 출력 투영 행렬을 점검해 연쇄 사고 생성 과정에서 자기 강화적 토큰 루프를 일으키는 구조적 불균형을 찾아냈다. 그리고 가중치의 0.016%만 수정해 같은 설정에서 정확도를 48.1%로 올렸다. 수학 예제에 과적합한 것이 아니라 결함 자체를 고쳤기 때문에 IFEval 지시 따르기 성능도 3배 올랐다고 보고된다. 영상은 이 결과가 하드웨어 예산과 엔지니어링 계획에 주는 의미를 생각해 보라고 권하며 마무리된다.


