
요약
⏱ 00:001. 문제 설정과 표현 방식의 한계
⏱ 00:00영상은 ML 엔지니어링 면접 대비를 위해 임베딩을 다루며, 온라인 쇼핑몰 결제 단계에서 칫솔과 어울리는 상품을 추천하는 업셀링 사례 하나를 끝까지 따라갑니다. 먼저 상품을 원-핫 인코딩으로 표현하는 고전적 방식을 소개합니다. 상품마다 고유한 위치를 주고 해당 칸만 1로 두는 방식이라 상품 수만큼 차원이 커지고, 로지스틱 회귀와 결합하면 상품마다 가중치를 따로 학습해야 합니다.
이 방식은 데이터가 충분한 대형 광고 시스템에서 오랫동안 쓰였지만, 롱테일 상품처럼 데이터가 희소한 영역에서 약하고 서로 관련 있는 상품도 서로 무관한 위치로 남는다는 한계가 있습니다. 새로 등록된 상품은 아예 표현이 없어 추천에서 빠지게 됩니다.
⏱ 02:102. 임베딩의 핵심 아이디어
⏱ 02:10임베딩은 각 상품을 64개 안팎의 짧고 밀집된 숫자 벡터로 바꿔, 비슷한 상품끼리 가깝게 놓이도록 학습한 표현입니다. 가깝다는 것은 보통 내적이나 코사인 유사도가 높다는 뜻입니다. 한 상품에 대해 배운 정보가 주변 상품으로 전달되므로 데이터가 적은 상품에도 도움이 되고, 벡터 인덱스를 쓰면 수십억 개 상품 중에서도 가까운 후보를 빠르게 찾을 수 있습니다.
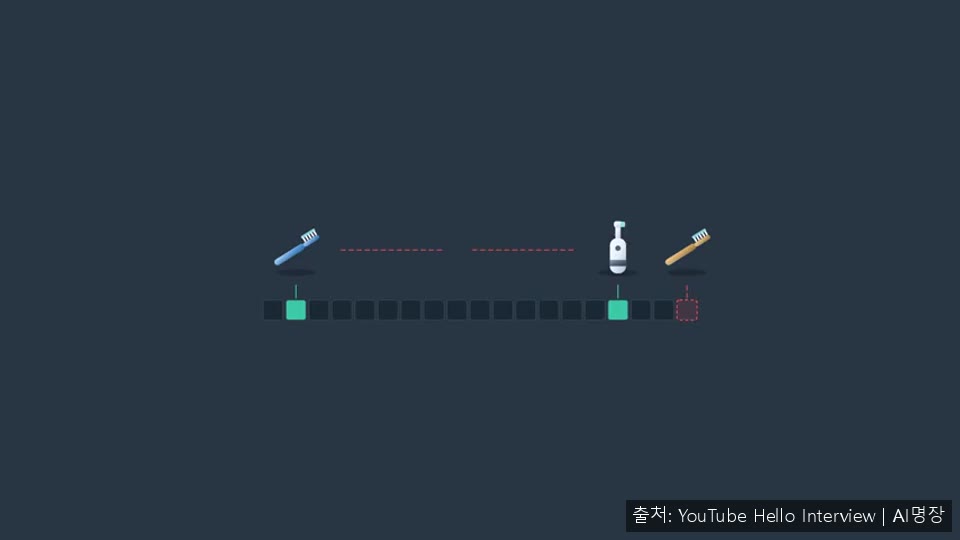
또한 임베딩은 랭킹 모델 같은 다른 모델의 입력으로 쓰일 수 있어 일종의 전이 학습 역할을 합니다. 다만 임베딩 자체에 고정된 의미가 있는 것은 아니며, 무엇이 가까이 놓일지는 어떤 목표로 학습했는지에 달려 있다는 점이 핵심입니다. 그래서 ML 엔지니어에게는 임베딩이 무엇을 담도록 만들지 정하는 일이 가장 중요한 결정이 됩니다.
⏱ 05:123. 행렬 분해로 임베딩 학습하기
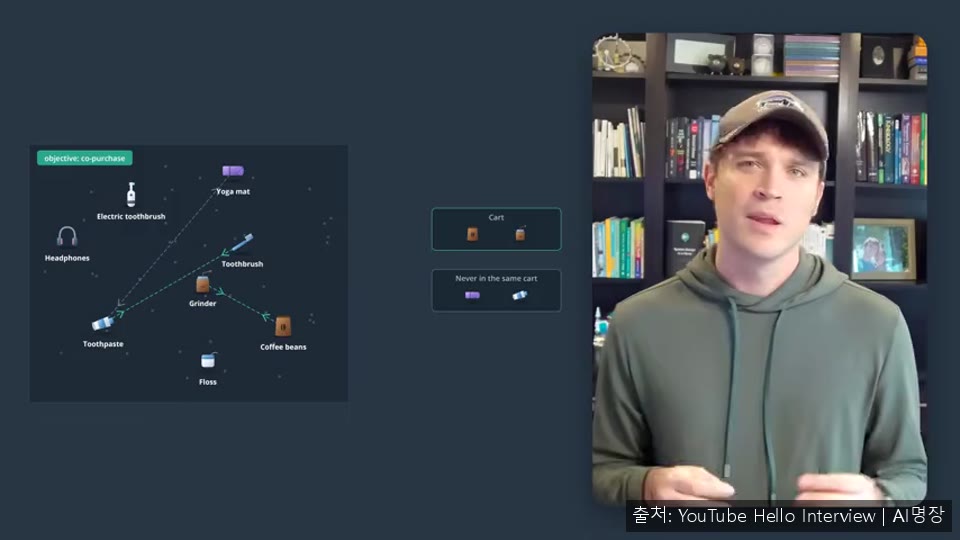
⏱ 05:12임베딩 학습의 가장 단순한 출발점은 상품마다 무작위 벡터를 주고 장바구니 신호로 조정하는 것입니다. 장바구니에 함께 담긴 상품끼리는 서로 끌어당기고(pull), 함께 담긴 적 없는 상품끼리는 밀어냅니다(push). 이를 행렬 분해로 구현하면 장바구니를 행, 상품을 열로 한 희소 행렬을 두고 장바구니 벡터 U와 상품 벡터 V를 찾아 그 내적으로 각 칸을 예측합니다.
⏱ 10:004. 룩업 테이블의 한계와 투 타워 모델
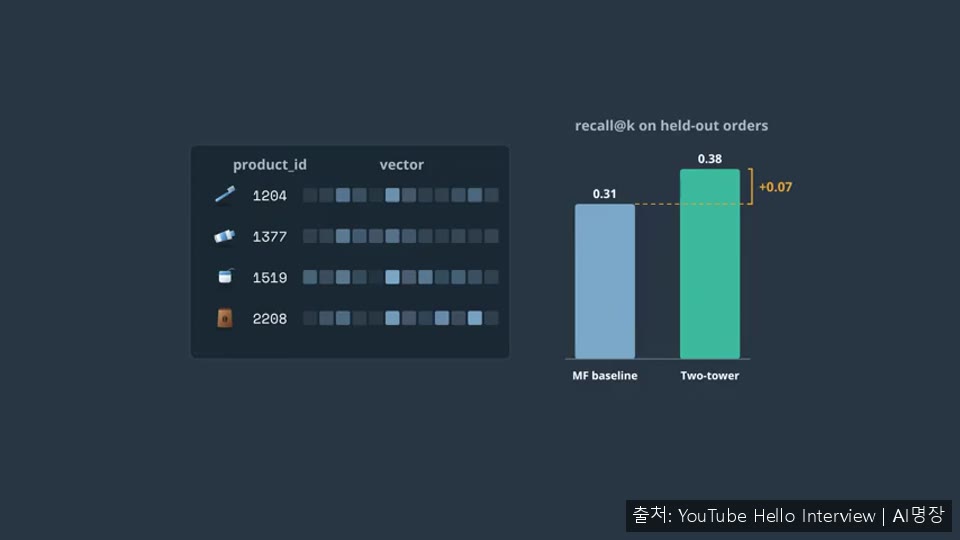
⏱ 10:00행렬 분해는 저렴하고 설명이 쉬워 베이스라인으로 쓸 가치가 있지만, 룩업 테이블이라는 근본 한계가 있습니다. 학습 때 없던 새 장바구니나 새 상품에는 행이 없으므로 벡터를 얻을 수 없고, 장바구니 평균으로 근사하면 조합의 의미가 흐려집니다. 이를 해결하는 방법으로 투 타워 모델이 소개됩니다.
⏱ 13:005. InfoNCE와 하드 네거티브
⏱ 13:00학습 데이터는 완료된 주문에서 항목 하나를 빼고, 나머지 장바구니를 쿼리, 뺀 항목을 정답으로 만드는 방식입니다. 배치 안에서 정답 쌍은 대각선에 놓이고, 나머지 쌍은 다른 장바구니의 상품이므로 추가 비용 없이 부정 샘플로 쓸 수 있습니다. 이것이 인-배치 네거티브이며, 대부분의 팀은 각 행을 분류 문제로 보는 InfoNCE 손실을 씁니다. 행마다 소프트맥스를 적용하고 정답의 음의 로그 확률을 최소화하는 방식입니다.
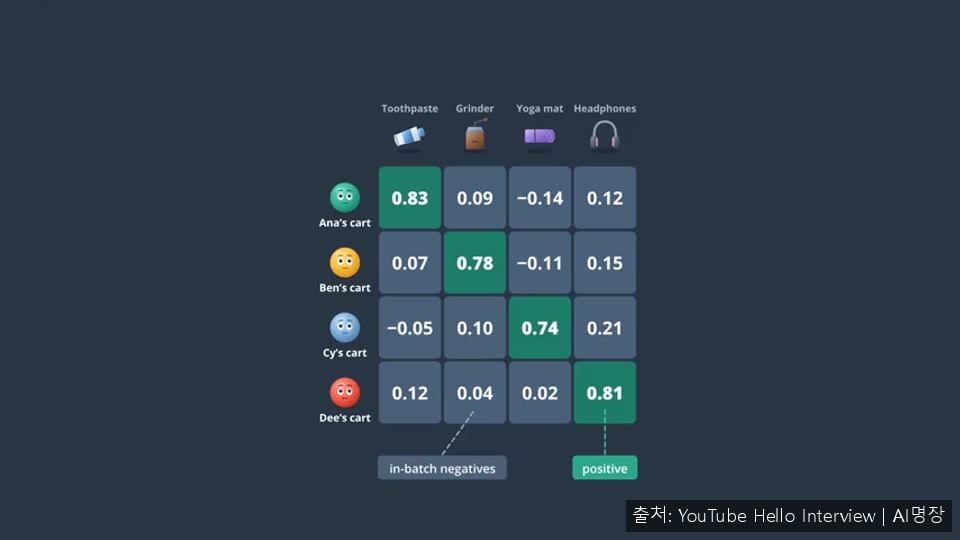
그래디언트는 쿼리를 정답 쪽으로 당기고 각 오답 쪽에서는 모델이 부여한 확률에 비례해 밀어냅니다. 그런데 학습이 진행되면 대부분의 부정 샘플이 쉬워져 기여가 0에 가까워지고, 학습 손실은 평탄해지지만 검증 품질은 낮을 수 있습니다. 품질을 좌우하는 것은 현재 모델이 헷갈려 하는 하드 네거티브입니다. 이를 찾으려면 전체 카탈로그를 현재 모델로 임베딩해 검색해야 하므로, 팀들은 몇 천 단계마다 스냅샷을 고정해 하드 네거티브를 추출하고 다음 갱신까지 배치에 섞는 식으로 타협합니다. 다만 가장 가까운 오답이 실제로는 아직 사지 않은 정답일 수 있어 상위 일부를 건너뛰거나 가중치를 낮추기도 합니다.
⏱ 16:006. 면접 답변 구성과 Triplet loss
⏱ 16:00면접에서는 임베딩이 어떻게 만들어지는지 데이터와 함께 설명해야 합니다. 완료된 주문으로 학습하고, 시간 단위로 데이터를 나눠 학습 이후 주문으로 평가하여 미래 정보가 새지 않게 한다는 점을 말하는 것이 좋습니다. 긍정 쌍이 무엇인지, 부정 데이터가 어디서 오는지, 평가가 누수 없이 이뤄지는지가 핵심 포인트입니다. 암기한 대본보다 본인의 지식과 경험을 전달하는 것이 중요합니다.
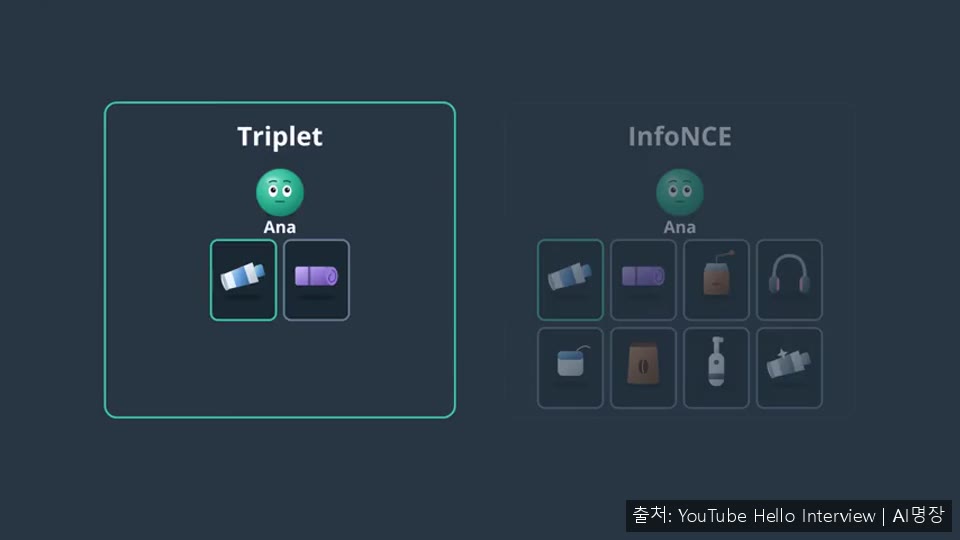
대조 손실은 InfoNCE만 있는 것이 아닙니다. Triplet loss는 닻, 긍정, 부정 세 가지를 한꺼번에 보고, 긍정이 부정보다 마진 이상 가까워지도록 요구합니다. 예를 들어 마진이 0.2라면 긍정과 부정의 차이가 마진을 넘는 순간 손실이 0이 되어 그래디언트가 멈추므로, 아직 틀렸거나 너무 가까운 삼중항에 학습이 집중됩니다. 배치가 클 때는 InfoNCE가 배치 내 모든 항목을 무료 부정 샘플로 쓸 수 있어 보통 더 유리하지만, Triplet loss는 직관적이어서 여전히 자주 쓰입니다.
⏱ 18:007. 증강·샴 구조와 그래프 임베딩
⏱ 18:00긍정 데이터는 웹 로그에서만 나오지 않습니다. 제품 사진은 자르기, 재압축, 색상 조정 등으로 원본의 변형본을 만들어 긍정 쌍으로 쓸 수 있으며, 이는 역방향 이미지 검색의 핵심 아이디어입니다. 쇼핑객이 찍은 흐린 스크린샷이 카탈로그 사진 옆에 놓이도록 크롭이나 회전, 노이즈를 무시하는 표현을 학습하는 것이 목표입니다. 두 타워가 같은 종류의 데이터를 다룰 때 양쪽이 하나의 인코더를 공유하는 구조를 샴 구조라고 부릅니다.
장바구니 외에도 제품과 카테고리, 브랜드, 구매자, 인플루언서가 연결된 그래프는 중요한 신호가 될 수 있습니다. 고전적으로 DeepWalk나 Node2vec은 랜덤 워크로 만든 노드 시퀀스를 Word2vec처럼 학습해, 윈도우 안의 노드는 가깝게, 무작위 노드는 멀게 만듭니다. 하지만 노드마다 벡터를 하나씩 학습하는 룩업 테이블이라 새 제품은 재학습 전까지 벡터가 없고 재학습 비용도 큽니다. 이를 극복하기 위해 GraphSAGE처럼 이웃 벡터를 모아 집계하고 노드 자체의 특징과 결합해 함수를 학습하는 방식이 소개됩니다.


