요약
⏱ 00:001. 도입: 답을 한 조각씩 쓰는 기계
⏱ 00:00챗봇이 몇 초 만에 자연스러운 답을 쓰는 것처럼 보이지만, 내부에서는 답을 아주 작은 조각 단위로 하나씩 이어 쓰고 있다는 점이 출발점입니다. 매번 '다음에 무엇이 오는가'라는 질문 하나에 답하는 방식입니다.
⏱ 00:412. 언어 모델의 본질: 다음 단어 확률 예측
⏱ 00:41언어 모델은 텍스트를 입력받아 단어 하나가 아니라 모델이 아는 모든 단어에 대한 확률 목록을 내놓는 함수입니다. 예를 들어 'the cat sat on the' 뒤에는 floor, bed 같은 단어에 각각 확률이 매겨집니다. 그중 하나를 골라 문장에 붙이고 같은 질문을 다시 던지는 과정을 수백 번 반복하면 한 단락이 완성됩니다.
다음 단어를 잘 맞히려면 화학 문장을 끝내기 위해 화학을 알아야 하고, 농담을 이어가려면 농담의 맥락을 이해해야 합니다. 그래서 다음 단어 예측을 잘 수행할수록 세계에 대한 지식을 많이 배우게 된다는 것이 핵심 논지입니다.
⏱ 01:323. 벡터, 행렬, 신경망의 기초
⏱ 01:32컴퓨터는 숫자만 다룰 수 있으므로 단어를 벡터, 즉 숫자 목록으로 바꿔야 합니다. 두 벡터의 내적은 두 화살표가 같은 방향을 얼마나 향하는지를 재는 값으로, 같은 방향이면 크고 직각이면 0, 반대 방향이면 음수가 됩니다. 영상은 이 내적을 유사도 측정이자 트랜스포머의 핵심 연산으로 강조합니다.
⏱ 03:594. 토큰, 임베딩, 위치 정보
⏱ 03:59문장은 먼저 토큰으로 잘게 나뉩니다. 흔한 단어는 통째로 하나의 토큰이 되고, 드문 단어는 익숙한 조각들로 쪼개집니다. 각 토큰은 어휘 목록의 번호로 바뀌고, 그 번호가 가리키는 긴 벡터인 임베딩으로 다시 변환됩니다. 한 대형 모델에서는 임베딩 벡터 하나가 12,288개의 숫자로 이루어진다고 소개됩니다.
학습 후 임베딩 공간에서는 비슷한 의미의 단어가 비슷한 방향에 모입니다. 강, 호수, 개울이 한 무리를 이루고 돈, 대출, 현금이 다른 무리를 이룹니다. 'man'에서 'woman'으로 가는 방향과 'king'에서 'queen'으로 가는 방향이 비슷하다는 예도 나옵니다.
그러나 bank는 강둑과 은행 사이 어딘가에 어정쩡하게 놓입니다. 혼자서는 어느 뜻인지 알 수 없다는 뜻이며, 이를 해결하는 것이 어텐션의 역할입니다. 또한 단어 순서를 구별하기 위해 위치 정보를 담은 벡터를 임베딩에 더해 줍니다.
⏱ 06:485. 어텐션: 쿼리, 키, 값과 소프트맥스
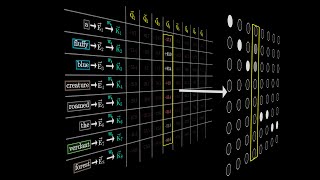
⏱ 06:48어텐션은 각 토큰이 문장 안의 다른 토큰을 살펴보고 관련 있는 정보를 가져와 자신의 벡터를 갱신하는 과정입니다. 각 토큰은 세 가지 벡터를 만듭니다. 무엇을 묻는지 나타내는 쿼리, 자신이 무엇을 담고 있는지 알리는 키, 실제로 전달할 정보인 값입니다. 한 토큰의 쿼리와 다른 토큰의 키를 내적해 관련도를 구하고, 그 점수를 소프트맥스로 합이 1인 가중치로 바꿉니다.
소프트맥스는 점수를 지수로 바꿔 모두 양수로 만들고 차이를 키운 뒤 전체 합으로 나누는 함수로 소개됩니다. 영상의 작은 예시에서 bank의 쿼리는 river 키와 큰 점수를 얻어 약 88%의 가중치를 받고, rain은 약 12%를 받습니다. 그 결과 bank의 벡터는 강과 관련된 의미 쪽으로 밀려납니다.
다음 단어를 예측할 때는 미래를 보면 안 되므로, 자기 이후 위치의 점수를 음의 무한대로 만들어 가중치를 0으로 가리는 마스킹이 적용됩니다. 또한 한 가지 관계만으로는 부족하므로 여러 어텐션 헤드가 병렬로 돌며, 학습 후에는 앞 단어 보기, 대명사와 명사 연결 등으로 역할이 나뉘는 경향이 있다고 설명됩니다.
⏱ 11:056. MLP와 층의 반복 구조
⏱ 11:05어텐션 다음에는 각 토큰 벡터에 독립적으로 적용되는 작은 신경망, 즉 MLP가 옵니다. 벡터를 약 네 배로 넓혔다가 비선형 함수를 적용하고 다시 줄이는 구조입니다. 연구에 따르면 모델의 사실 지식 상당 부분이 이 블록에 저장되어 있으며, 영상은 이 블록이 전체 파라미터의 약 3분의 2를 차지한다고 말합니다.
중요한 설계는 어텐션과 MLP가 벡터를 대체하지 않고 갱신값을 더해 준다는 점입니다. 벡터는 층을 따라 흐르는 흐름처럼 보이고, 각 블록은 그 흐름을 읽고 조금씩 덧써 넣습니다. 블록 전에 벡터를 정규화해 값의 범위를 안정시키므로 수십 층이 쌓여도 학습이 안정적으로 유지됩니다.
이런 한 쌍의 층이 수십 번 반복되며, 아래층은 문법과 가까운 단어 관계를, 위층은 더 넓은 의미를 담당하는 경향이 있습니다. 마지막 토큰의 벡터는 앞선 내용을 요약한 상태가 되고, 이를 언임베딩 행렬로 곱해 어휘 전체에 대한 점수를 얻은 뒤 소프트맥스로 확률을 만듭니다. 가장 높은 확률을 고르거나 temperature 설정으로 무작위성을 조절해 다음 토큰을 정합니다.
⏱ 13:517. 학습: 기울기와 경사 하강법
⏱ 13:51가중치는 처음에는 무작위 숫자이므로 모델의 첫 추측은 엉터리입니다. 학습은 방대한 텍스트에서 각 위치의 다음 토큰을 예측하게 하고, 정답 토큰에 준 확률의 음의 로그로 손실을 잽니다. 손실이 작을수록 잘 맞힌 것입니다.
미적분으로 각 가중치를 어느 방향으로 움직여야 손실이 줄어드는지 계산하며, 이를 기울기라고 합니다. 역전파 알고리즘은 이 기울기를 모든 가중치에 대해 한 번에 효율적으로 구합니다. 그 방향으로 아주 작은 걸음씩 내려가는 과정을 수조 개 토큰에 걸쳐 반복하는 것이 경사 하강법입니다. 이 과정을 거치며 예측은 엉터리에서 문법, 사실, 그리고 이해에 가까운 모습으로 발전합니다.
마지막으로 챗봇은 대화 데이터와 사람의 피드백으로 추가 학습을 받아, 단순히 텍스트를 이어 쓰는 대신 도움이 되는 답을 하도록 다듬어집니다. 영상은 전체 흐름을 토큰화, 벡터와 위치, 어텐션, MLP, 층 반복, 다음 토큰 확률 선택의 순서로 요약하며 마무리합니다.