요약
⏱ 00:001. 강좌 소개와 학습 범위
⏱ 00:00강좌는 벡터, 코사인 유사도, 유클리드 거리 같은 기초 개념부터 시작해 벡터 데이터베이스를 처음부터 차근차근 설명합니다. 토큰화와 임베딩 모델, 구글 Gemini 임베딩을 활용한 실시간 데모, 벡터 DB의 저장 구조와 IVF·HNSW 같은 인덱스 방식을 차례로 다룹니다.
⏱ 03:422. 벡터 데이터베이스의 정의와 전체 흐름
⏱ 03:42첫날 강의는 벡터 데이터베이스가 무엇인지 정의하는 데서 출발합니다. 벡터 데이터베이스는 임베딩 모델이 만든 고차원 벡터를 저장하고 인덱싱하여 의미 기반 검색을 가능하게 하는 데이터베이스입니다.
⏱ 11:103. 기존 데이터베이스의 한계와 필요성
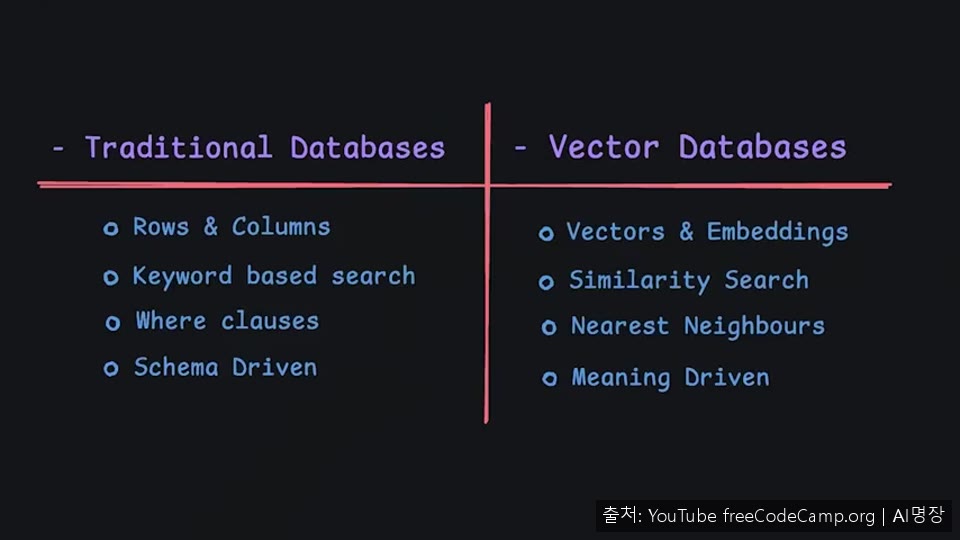
⏱ 11:10텍스트, PDF, 오디오, 이미지 같은 비정형 데이터는 기존 데이터베이스에 저장은 할 수 있어도 의미를 기준으로 대규모 검색하기는 어렵다고 설명합니다. 기존 DB는 정확한 키워드 일치, 범위 조회, 조인 같은 작업에 최적화되어 있어서, 질의에 쓰인 단어가 문서에 없으면 같은 뜻의 정보도 찾지 못합니다.
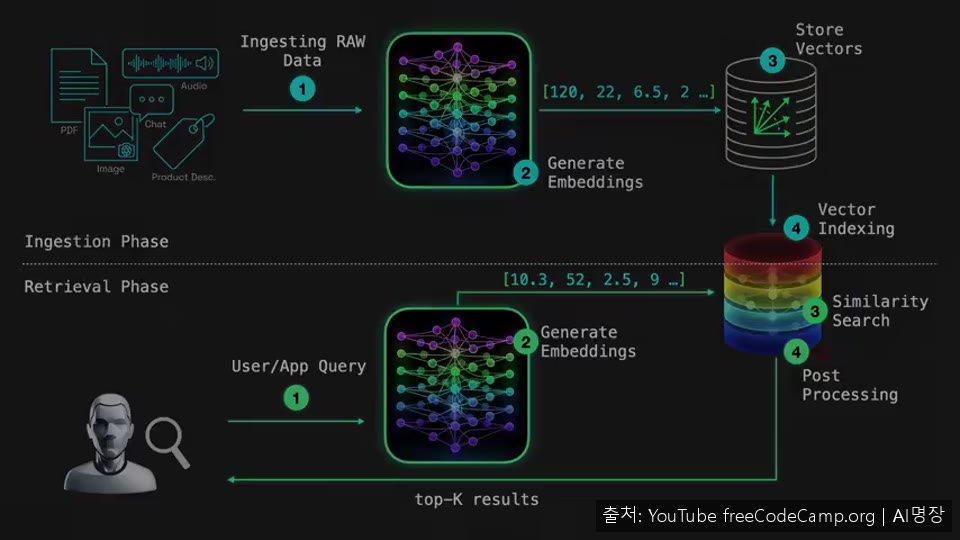
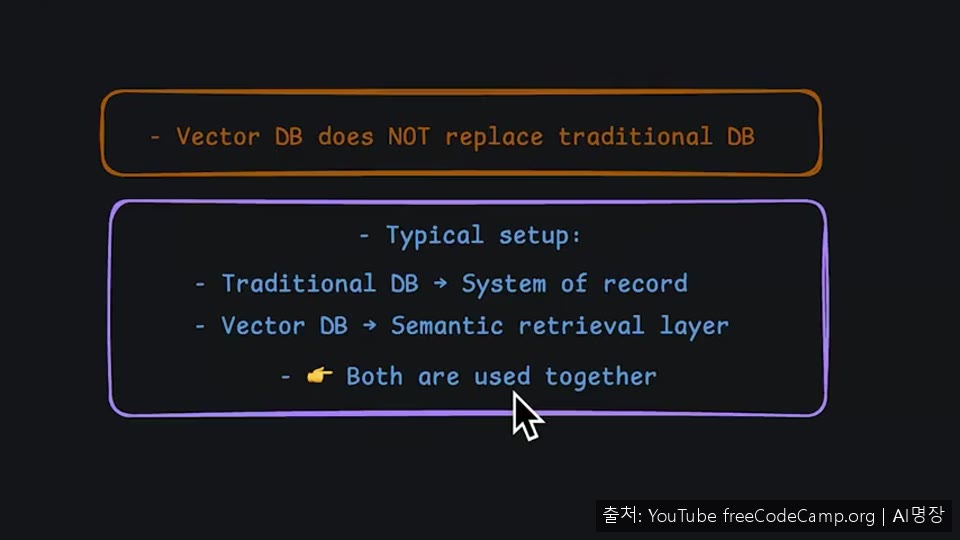
그래서 벡터 DB는 이런 데이터를 벡터로 바꿔 저장하고 뜻에 따라 찾는 데 초점을 맞춥니다. 다만 벡터 DB가 기존 DB를 대체하는 것은 아니며, 실무에서는 기존 DB를 기록 시스템으로 두고 그 위에 의미 검색 계층을 얹는 구성이 흔하다고 말합니다.
⏱ 17:144. 검색이 빠른 이유와 기존 DB와의 차이
⏱ 17:14벡터 DB가 빠른 이유는 모든 벡터를 하나씩 비교하지 않기 때문이라고 설명합니다. 100만 개 이미지에서 가장 비슷한 것을 찾으려고 전부 훑으면 시간이 선형으로 늘어나므로, 데이터베이스는 벡터 인덱스를 미리 구축해 근사 최근접 이웃 검색으로 후보를 빠르게 좁힙니다.
⏱ 19:345. 추천 시스템을 중심으로 한 활용 사례
⏱ 19:34활용 사례로 추천 시스템을 집중적으로 소개합니다. 넷플릭스, 아마존, 유튜브 같은 플랫폼의 추천은 사용자와 아이템을 모두 벡터로 바꾸어 다룬다고 설명합니다. 사용자 벡터에는 클릭, 시청, 구매 같은 행동 기록이 담기고, 아이템 벡터에는 리뷰나 제품 사양 같은 특징이 담깁니다.
⏱ 22:396. 벡터의 정의와 차원 이해하기
⏱ 22:39둘째 날 강의는 벡터가 무엇인지 기초부터 다룹니다. 머신러닝에서 벡터는 숫자를 일렬로 늘어놓은 1차원 배열이며, 각 숫자가 객체의 특징을 나타냅니다. 숫자 하나는 스칼라, 배열 안에 다시 배열이 들어가면 행렬이 되므로 벡터의 예시가 아니라고 구분합니다.
벡터의 차원은 그 벡터가 가진 특성의 개수와 같습니다. 예를 들어 자동차를 속도 하나로만 표현하면 1차원 벡터가 되어 수직선 위의 한 점으로 나타낼 수 있습니다. 이어서 자동차를 더 추가해 특징 값이 얼마나 가까운지로 비슷함을 따지는 방식을 소개하기 시작합니다. 모든 벡터가 임베딩은 아니며, 임베딩은 다음 강의에서 다룬다고 덧붙입니다.