요약
⏱ 00:001. 벡터 데이터베이스 논쟁의 배경
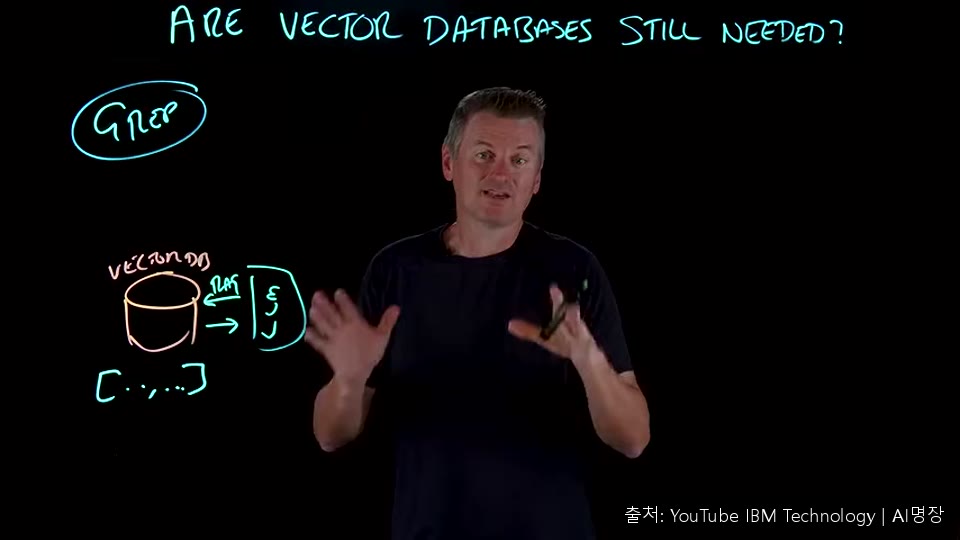
⏱ 00:00온라인에서는 벡터 데이터베이스를 1973년에 나온 텍스트 검색 도구 grep으로 대체하자는 논의가 활발하다. 이런 주장은 grep 방식이 더 단순하고, 별도의 인덱스가 필요 없으며, 인덱스가 시간이 지나 낡아지는 문제도 없다는 점을 내세운다.
발표자는 이 주장을 출발점으로 삼아 벡터 데이터베이스가 정말 필요한지 따져 보겠다고 밝힌다.
⏱ 00:282. 벡터 데이터베이스의 개념
⏱ 00:28벡터 데이터베이스도 다른 데이터베이스처럼 내용을 저장하지만, 그 내용을 임베딩 형태로 저장한다는 점이 다르다. 임베딩은 고차원 공간의 한 점을 나타내는 숫자들의 나열이며, 의미가 비슷한 내용일수록 공간에서 가까이 놓이도록 배치된다.
⏱ 01:153. 검색 방식의 네 단계 피라미드
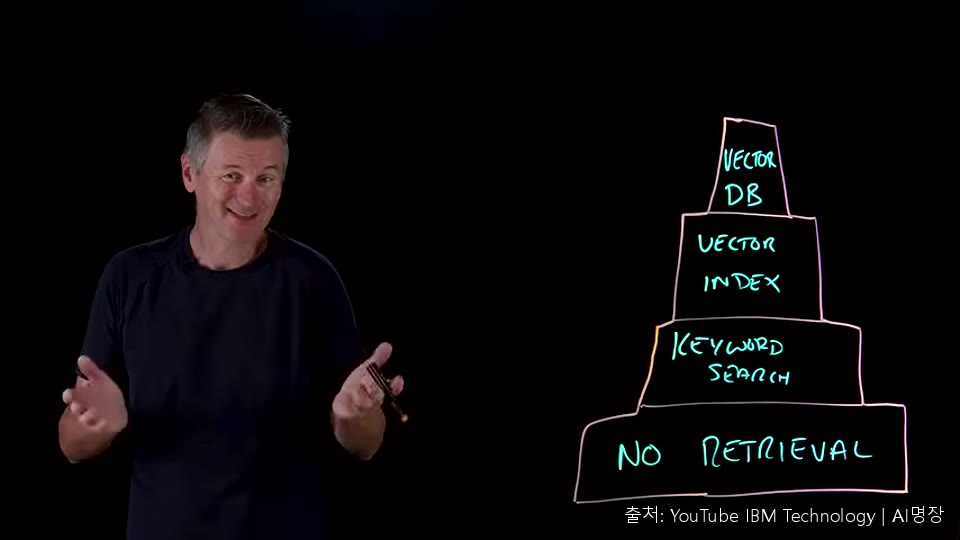
⏱ 01:15발표자는 검색 방식을 네 단계의 피라미드로 설명한다. 가장 아래 단계는 검색 없이 필요한 내용을 전부 LLM 프롬프트에 붙여 넣는 방식이고, 가장 위 단계는 전용 벡터 데이터베이스다.
핵심 원칙은 작업 특성이 요구할 때만 위 단계로 올라가라는 것이다. 이유 없이 최상위로 가면 불필요한 복잡성만 떠안게 된다.
⏱ 01:494. 벡터 데이터베이스가 필요 없다는 세 가지 근거
⏱ 01:49첫째, 에이전트 검색(agentic search)이다. 시맨틱 검색의 대안은 단어 일치에 기반한 키워드 검색이며, grep이 바로 이 방식이다. 키워드 검색은 단순해 보이지만, 자율적인 AI 에이전트는 검색을 한 번에 성공시킬 필요 없이 결과를 읽고 검색어를 고쳐 반복할 수 있다. 여러 번 시도하면 키워드 검색도 벡터 검색만큼 쓸모가 있을 수 있다.

둘째, 긴 컨텍스트 윈도우다. 최신 모델은 몇 년 전보다 훨씬 많은 텍스트를 입력받을 수 있어, 검색 없이 필요한 정보를 모두 넣으면 된다는 주장이다.
⏱ 05:275. 상위 단계로 올라가야 하는 이유
⏱ 05:27발표자는 세 가지 근거가 피라미드의 각 단계와 대응한다고 정리한다. 긴 컨텍스트는 가장 아래 단계, 에이전트 키워드 검색은 그 위 단계, 임베딩 비용 문제는 기존 데이터베이스의 벡터 인덱스 단계에 해당한다.
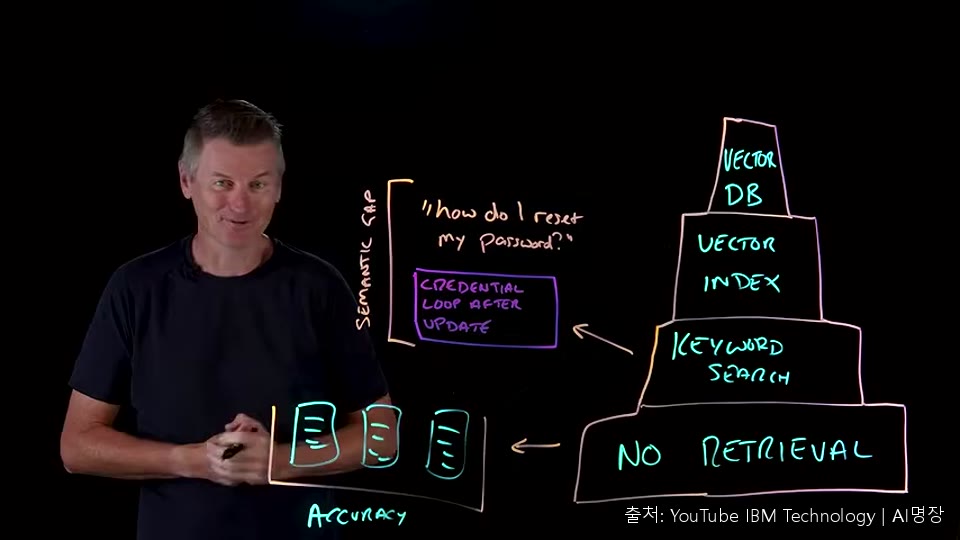
그러나 발표자는 상위 단계로 올라갈 이유가 여전히 있다고 본다. 컨텍스트를 가득 채우면 토큰 처리 비용이 늘 뿐 아니라, 불필요한 내용이 많아져 모델 정확도가 떨어지는 컨텍스트 과부하 문제가 생긴다. 말뭉치가 작다면 검색 없이도 괜찮지만, 규모가 커지면 필요한 부분만 가져오는 검색이 낫다.
키워드 검색에도 한계가 있다. 예를 들어 사내 지원 도구에서 사용자가 비밀번호를 어떻게 재설정하냐고 물었을 때, 정답 티켓의 제목이 전혀 다른 단어로 되어 있으면 키워드 검색은 아무것도 찾지 못한다. 두 문장은 의미가 같지만 임베딩 공간에서는 가까운 이웃이 된다. 이처럼 질의와 정보의 표현이 달라 생기는 간극을 시맨틱 갭이라고 하며, 시맨틱 검색은 이 간극을 메우기 위해 만들어졌다.
⏱ 07:166. 벡터 인덱스와 전용 벡터 데이터베이스의 차이
하지만 벡터가 수백만 개 이상으로 늘어나 모두 메모리에 올려 두어야 하면 일반 데이터베이스에 부담이 된다. 전용 벡터 데이터베이스는 수십억 개의 벡터를 담고도 밀리초 단위로 응답하도록 설계되어 있어, 이런 규모에서는 더 알맞은 선택이 된다.
⏱ 08:187. 결론: 두 가지 질문으로 판단하기
⏱ 08:18발표자는 벡터 데이터베이스가 필요한지에 대한 답을 두 질문으로 나눈다. 첫째, 벡터 검색이 필요한가. 둘째, 필요하다면 전용 벡터 데이터베이스가 필요한가.
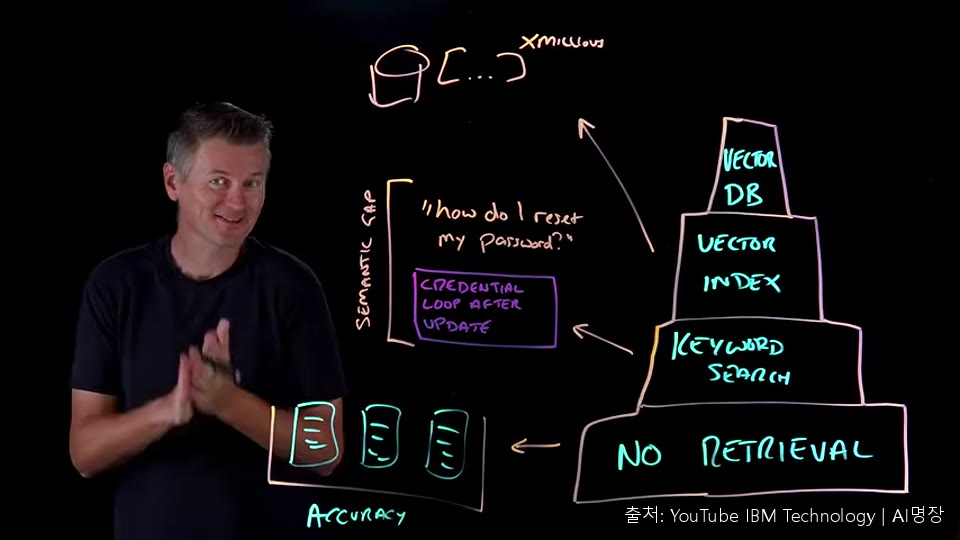
정보가 컨텍스트 윈도우에 충분히 들어간다면 검색 자체가 필요 없을 수 있다. grep 같은 키워드 검색과 에이전트의 반복 호출로 충분한 경우도 있다. 시맨틱 갭이 문제라면 벡터 인덱스를 만드는 것이 좋고, 벡터 수가 수백만 개 이상으로 많을 때 전용 벡터 데이터베이스가 의미를 가진다. 발표자는 시청자에게 자신의 작업이 피라미드의 어느 단계에 있는지 댓글로 알려 달라고 청하며 마무리한다.