요약
14개 세션으로 구성된 트랜스포머 강의의 앞부분으로, 'I love tea' 한 문장을 따라가며 토큰화, 임베딩, 위치 인코딩, 셀프 어텐션의 원리를 차례로 설명한다. 각 단계마다 GPT-2 실험과 손계산 예시를 함께 보여주어 개념을 수치로 확인하게 한다.
⏱ 00:001. 강의 개요와 트랜스포머의 큰 그림
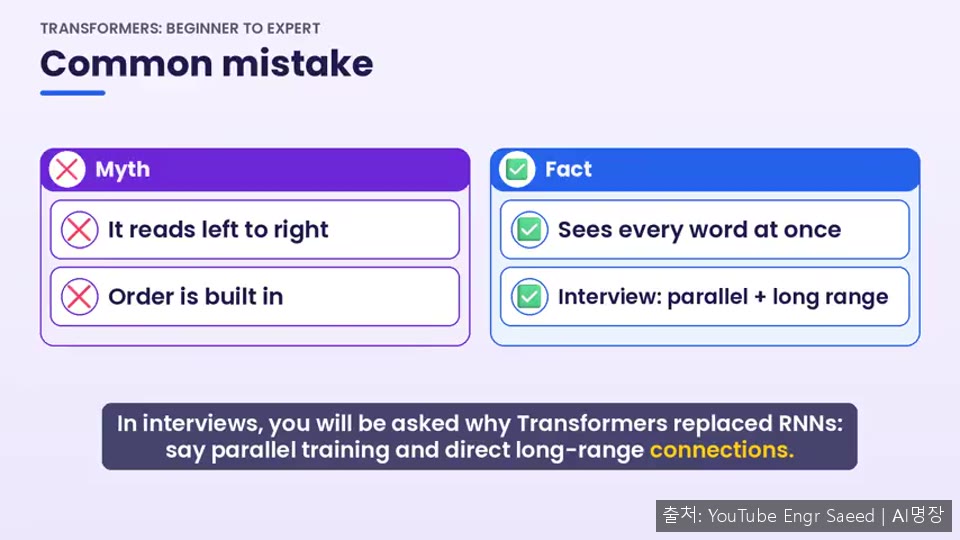
⏱ 00:00강의는 14개 세션으로 구성되며, 'I love tea'라는 한 문장을 끝까지 따라가며 모델의 각 부분을 살펴본다. 트랜스포머는 2017년 논문에서 나온 구조로, 문장 전체를 한 번에 읽고 모든 단어가 다른 모든 단어를 참조해 의미를 정한다.

순환 신경망(RNN)은 단어를 하나씩 순서대로 읽어 학습이 느리고 먼 단어의 정보를 잊기 쉽지만, 트랜스포머는 모든 단어를 병렬로 처리해 GPU를 효율적으로 쓴다. 전체 흐름은 텍스트를 토큰으로 나누고, 토큰을 임베딩과 위치 신호로 바꾼 뒤, 인코더와 디코더 블록을 거쳐 소프트맥스로 다음 단어를 고르는 순서다.
원래 모델은 인코더와 디코더 각각 6개 블록으로 이루어졌고, ChatGPT와 Claude는 디코더 블록만, BERT는 인코더 블록만 쌓아 만든 구조라는 점도 짚는다. 트랜스포머는 단어를 왼쪽에서 오른쪽으로 읽지 않고 동시에 보므로 어순 정보를 따로 넣어야 한다는 점을 강조한다.
⏱ 03:472. 토큰화: 문장을 숫자로 바꾸기
⏱ 03:47GPT-2는 'I love tea'를 40, 1842, 8887이라는 세 숫자로 본다. 토큰화는 텍스트를 작은 조각인 토큰으로 나누고 각 조각에 ID 번호를 붙이는 단계이며, 신경망이 문자가 아닌 숫자만 계산할 수 있기 때문에 필요하다.
과정은 텍스트 정리, 고정된 어휘집으로 분할, ID 조회, 문장 시작과 끝을 알리는 특수 토큰 추가의 네 단계다. BPE(GPT), WordPiece(BERT), SentencePiece(T5, LLaMA)가 대표적인 서브워드 방식이며, 자주 쓰는 단어는 통째로 남고 드문 단어는 조각으로 나뉜다.
같은 뜻의 문장이라도 영어 중심으로 학습된 어휘집에서는 우르두어 문장이 영어보다 훨씬 많은 토큰을 차지한다. API 비용과 문맥 길이 제한이 단어가 아닌 토큰 단위로 계산되는 이유가 여기에 있으며, 한 토큰이 항상 한 단어가 아니라는 점도 기억할 필요가 있다.
⏱ 06:473. 임베딩: 의미를 숫자 벡터로 표현하기
⏱ 06:47임베딩 층은 토큰 ID를 의미를 담은 숫자 벡터로 바꾼다. 비슷한 의미의 단어는 비슷한 벡터를 가지므로, 한 단어에서 배운 내용을 다른 단어에도 활용할 수 있다. GPT-2 실험에서 tea는 coffee와의 코사인 유사도가 0.62로, engine(0.23)보다 훨씬 높게 나타났다.

작동 방식은 어휘 크기만큼의 행을 가진 임베딩 행렬을 두고, 각 토큰 ID에 해당하는 행을 골라오는 것이다. 이후 벡터에 모델 차원 수의 제곱근을 곱해 임베딩과 위치 정보의 크기를 맞춘다. 이 행렬의 값은 사람이 정하지 않고 학습 과정에서 자동으로 만들어진다.
임베딩은 문맥을 알지 못한다는 한계도 있다. 'river bank'와 'bank account'의 bank는 같은 벡터를 가지며, 문맥에 따른 의미 차이는 이후 어텐션 단계에서 반영된다. 임베딩 다음에 어텐션이 필요한 이유를 설명할 때 바로 이 점이 핵심이다.
⏱ 09:454. 위치 인코딩: 단어 순서 정보 더하기
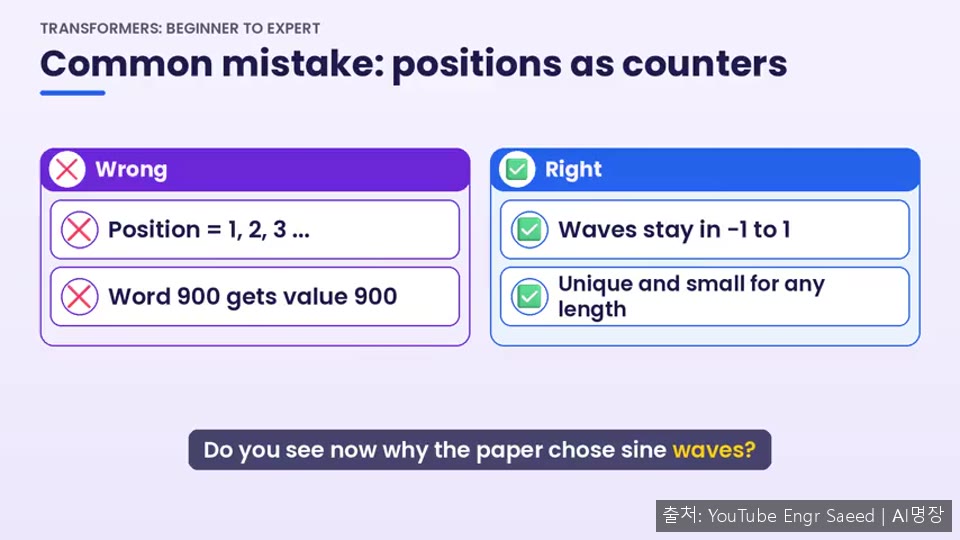
⏱ 09:45'dog bites man'과 'man bites dog'은 단어 구성이 같아 위치 정보가 없으면 트랜스포머에게 같은 문장으로 보인다. 위치 인코딩은 단어의 순서 정보를 임베딩에 더해 이 문제를 해결한다. 어텐션은 단어 쌍을 비교할 뿐 순서를 알려주지 않기 때문에 이 과정이 반드시 필요하다.

원 논문은 사인과 코사인 파동을 사용한다. 짝수 차원에는 사인, 홀수 차원에는 코사인을 쓰고 차원마다 파동의 속도를 다르게 설정한다. 낮은 차원은 빠르게 변해 가까운 위치를 구별하고, 높은 차원은 천천히 변해 먼 위치를 구별하며, 이는 시계의 초침과 시침에 비유할 수 있다.
강의는 차원 수 4인 예시로 각 위치의 값을 직접 계산해 보여준다. 위치를 1, 2, 3처럼 단순 카운터로 쓰면 긴 문서에서 큰 숫자가 의미 값을 압도하므로 적합하지 않고, 파동 값은 항상 -1과 1 사이에 머문다는 장점이 있다. 최근 LLaMA는 RoPE 방식을 쓰고, GPT-2와 BERT는 위치 벡터를 학습으로 얻는다.
⏱ 13:085. 셀프 어텐션: 쿼리, 키, 값의 원리
⏱ 13:08'The animal didn't cross the street because it was tired'에서 it이 animal을 가리킨다는 사실을 모델이 알아내는 방법이 셀프 어텐션이다. 셀프 어텐션은 각 단어가 같은 문장의 다른 단어들로부터 관련도에 따라 가중치를 두고 정보를 모으는 연산이다.
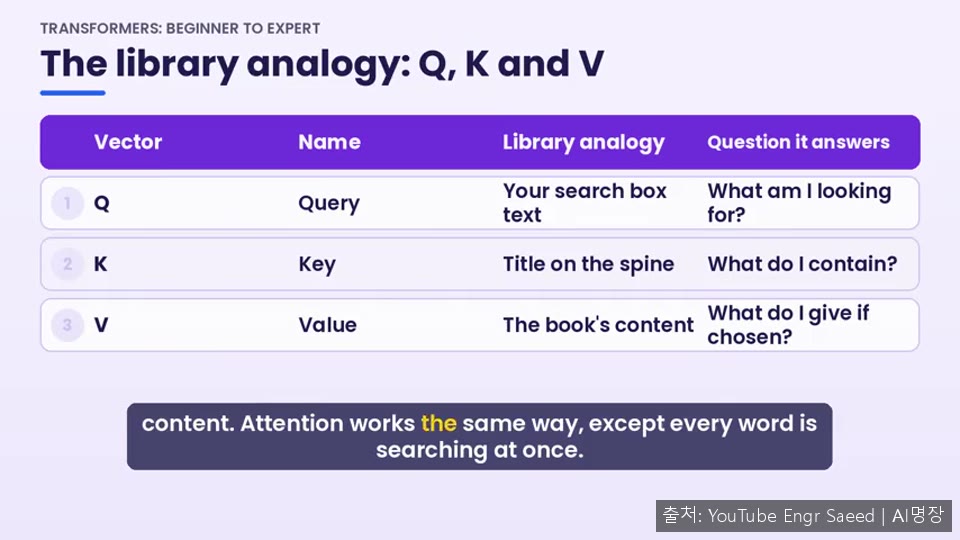
이 과정은 도서관 검색에 비유된다. 각 단어는 쿼리(무엇을 찾는가), 키(무엇을 담고 있는가), 값(선택되었을 때 주는 내용)이라는 세 벡터를 만들며, 이는 입력 벡터에 학습된 가중치 행렬 WQ, WK, WV를 곱해 얻는다. 같은 입력을 세 가지 다른 관점으로 바라보는 셈이다.
계산은 쿼리와 키의 내적으로 점수를 내고, 키 차원의 제곱근으로 나눈 뒤, 소프트맥스로 0과 1 사이 가중치를 만들고, 값을 가중합하는 순서다. 전체는 softmax(Q K^T / sqrt(dk)) V 한 줄로 요약된다. 디코더의 마스크드 셀프 어텐션과 인코더-디코더 간 크로스 어텐션도 같은 수식을 다른 입력에 적용한 것이다.
⏱ 14:146. 셀프 어텐션 손계산 예제 시작
⏱ 14:14다음 세션에서는 'tea'라는 단어 하나에 대해 어텐션 값을 손으로 계산한다. 계산을 쉽게 하기 위해 키와 값을 2차원으로 줄이고, tea의 쿼리는 (1, 1)로 둔다. I, love, tea의 키 값을 가정하고 어떤 키가 쿼리와 가장 잘 맞는지 먼저 짐작해 보도록 유도한다.
강의는 이 예제를 통해 tea의 어텐션 가중치 51%가 love에 집중되는 이유를 단계별로 확인하겠다고 예고한다. 작은 숫자를 쓰는 이유는 계산기로 모든 단계를 검증할 수 있게 하기 위함이며, 실제 모델도 같은 연산을 더 큰 벡터로 수행한다.