요약
⏱ 00:001. 다음 토큰을 예측하는 반복 과정
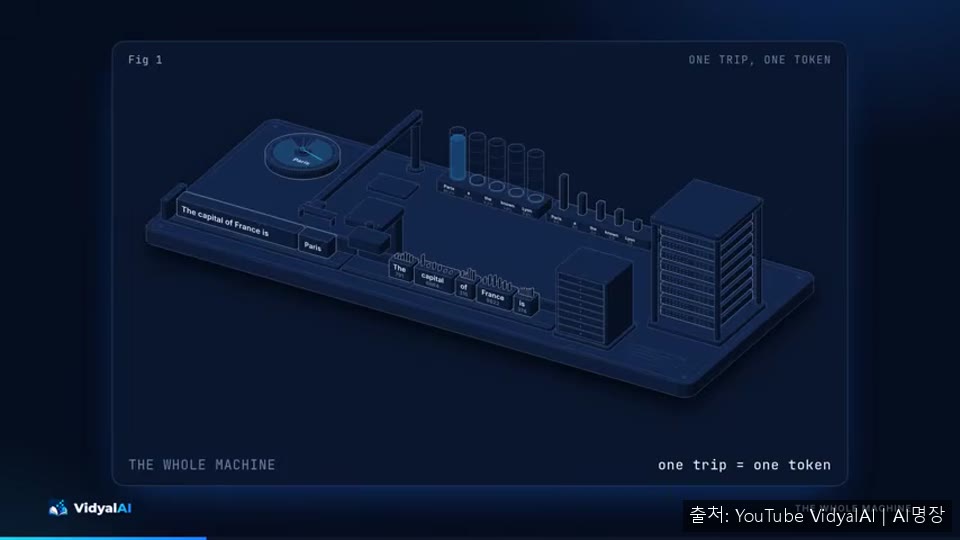
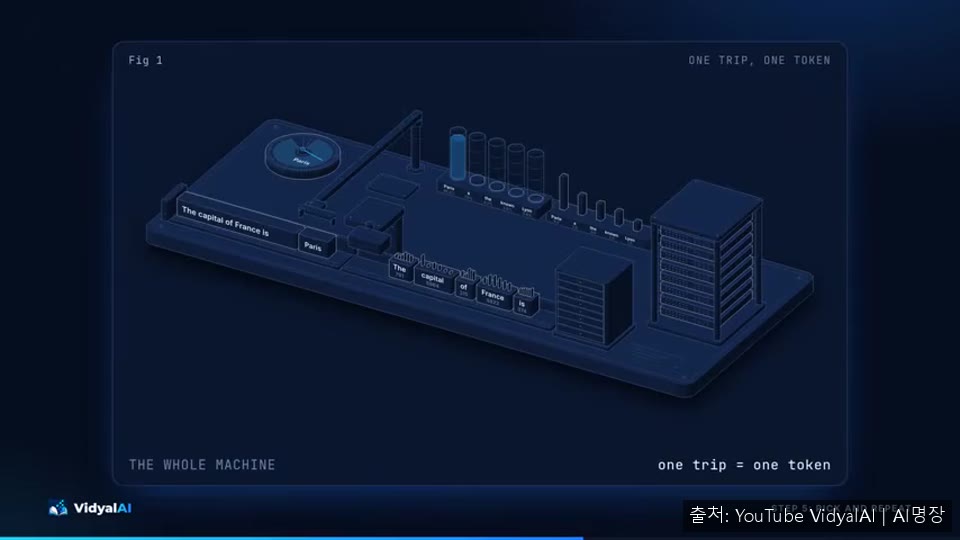
⏱ 00:00챗봇에 'The capital of France is'를 입력하면 모델은 답을 어디서 찾아보는 것이 아니라, 파일에 담긴 수치로 다음 토막(토큰)의 확률을 계산합니다. 가장 확률이 높은 토큰 Paris를 골라 문장 뒤에 붙이고, 모델 전체를 다시 실행하는 과정을 반복하는 것이 핵심입니다. 같은 질문에 답이 달라지는 이유도 이 확률 기반 선택에 있습니다.
⏱ 00:542. 전체 구조 한눈에 보기
⏱ 00:54LLM의 역할은 주어진 텍스트 뒤에 올 작은 조각인 토큰을 예측하는 것 하나입니다. 스마트폰 자동완성과 달리 LLM은 지금까지 쓴 글 전체를 보고 판단하며, 이 과정에서 문법, 사실, 추론 패턴을 함께 익히게 됩니다.
⏱ 02:463. 토큰화와 임베딩
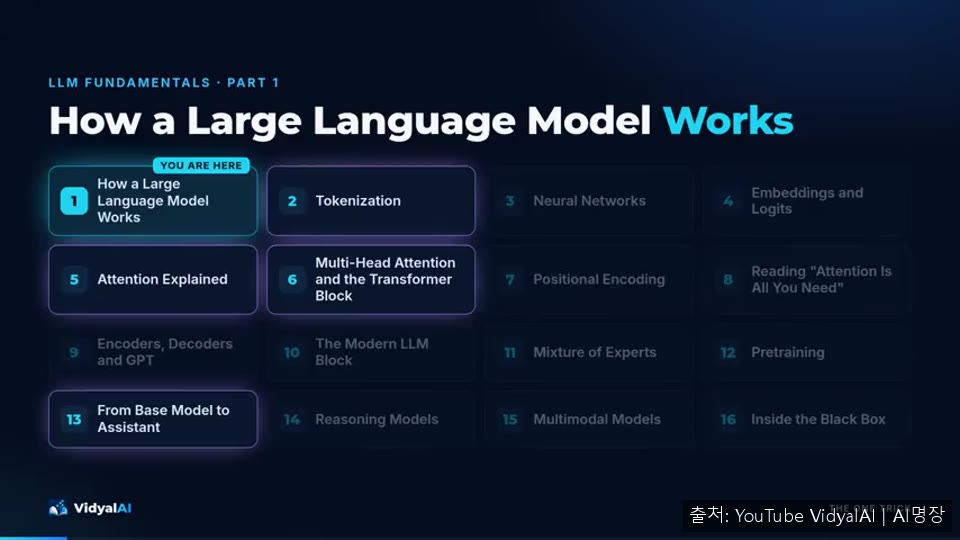
⏱ 02:46모델은 숫자만 다룰 수 있으므로 토크나이저가 텍스트를 고정된 어휘집의 조각으로 나누고, 각 조각을 ID 번호로 바꿉니다. 영어에서는 토큰 하나가 대략 글자 4개, 단어로는 약 3/4 정도에 해당하며, 토큰 수는 과금과 문맥 길이 제한의 기준이 됩니다. 어휘 크기는 GPT-2 5만 257개, Llama 3 12만 8천 개라는 예시가 나옵니다.
⏱ 04:394. 트랜스포머 블록: 어텐션과 MLP
⏱ 04:39트랜스포머 블록은 같은 구조가 여러 층 쌓인 형태이며, GPT-3는 96개, Llama 3.1 405B는 126개를 사용합니다. 각 블록은 어텐션과 MLP 두 부분으로 이루어집니다. 어텐션에서는 각 토큰이 앞선 토큰들을 바라보며 지금 중요한 토큰이 무엇인지 가중치로 정하고, 'is' 위치에서는 capital과 France에 큰 가중치를 둡니다.
MLP는 각 토큰을 따로 처리하며, 모델이 가진 지식이 많이 저장된 곳으로 보입니다. 블록은 결과를 대체하지 않고 더해 가므로, 토큰마다 공유 메모지에 층마다 메모를 덧붙이는 것과 비슷합니다. 어텐션은 거리와 상관없이 앞선 모든 토큰과 한 번에 직접 연결됩니다.
⏱ 05:265. 로짓, 소프트맥스, 샘플링과 온도
⏱ 05:26마지막 블록을 거친 벡터는 어휘의 모든 토큰에 대한 점수, 즉 로짓이 됩니다. 소프트맥스 함수는 이 점수에 지수를 취해 합이 1이 되는 확률로 바꾸는데, 점수 차이가 작아도 확률 차이는 크게 벌어질 수 있습니다. 예시에서 Paris는 'a'보다 점수가 2.5점 앞서며, 소프트맥스 후 약 85.2%의 확률을 얻습니다.
이후 샘플링으로 토큰을 고릅니다. 가장 높은 확률만 취하는 그리디 디코딩은 예측 가능하지만 밋밋해지기 쉽습니다. 온도 T는 모든 로짓을 T로 나눠 분포를 바꾸며, 1보다 낮으면 선두가 강해지고 1보다 높으면 분포가 평평해져 창의성과 오류가 함께 늘어납니다. 500토큰 답변을 만들려면 모델 전체를 500번 통과해야 하며, 이 점이 속도와 비용을 설명합니다.
⏱ 07:496. 매개변수와 학습 방식
⏱ 07:49지금까지 본 계산은 학습으로 얻은 매개변수, 즉 파라미터에 의존합니다. 자동완성이 구절을 저장한다면 LLM은 수십억 개의 숫자를 저장하는 셈이어서, 정보의 출처를 말하지 못하거나 확신 있게 틀린 내용을 지어낼 수 있습니다. 영상은 GPT-3의 매개변수가 약 1750억 개라는 것을 블록별 계산으로 맞춰 보이며, 2바이트씩 저장하면 가중치만 약 350GB라고 설명합니다.
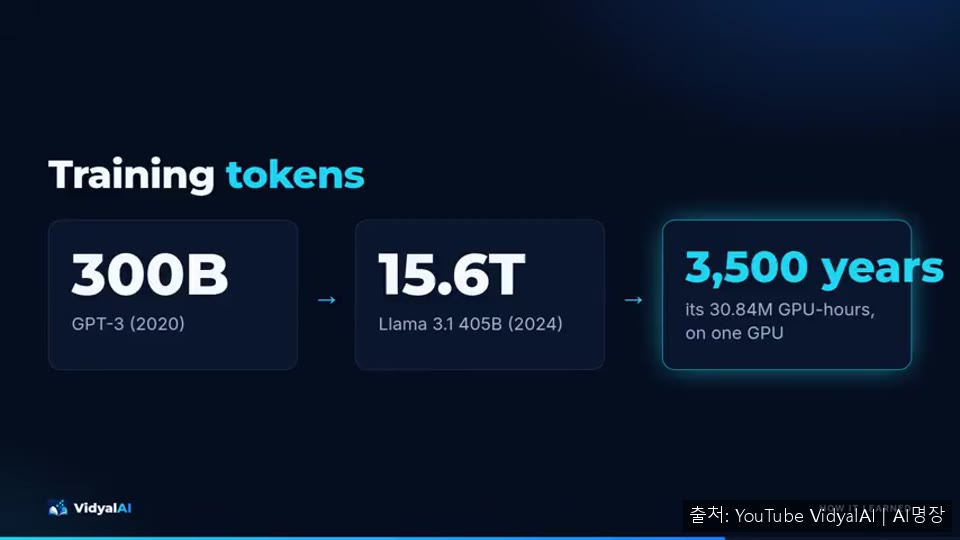
학습은 실제 텍스트에서 다음 토큰을 예측하고, 손실로 얼마나 틀렸는지 측정한 뒤, 역전파로 파라미터를 조금씩 조정하는 과정을 수없이 반복하는 방식입니다. 별도의 정답 라벨 없이 텍스트 자체가 정답이 되는 셈입니다. GPT-3는 3000억 토큰, Llama 3.1 405B는 15.6조 토큰으로 학습했다고 소개됩니다.
⏱ 09:437. 기본 모델, 챗 모델, 그리고 최근 발전
⏱ 09:43웹 텍스트만 학습한 모델은 기본 모델(base model)이며, 질문에 답하기보다 질문을 더 던지는 경향이 있습니다. 그래서 챗 모델은 추가 학습을 한 번 더 거칩니다. InstructGPT 논문에서는 13억 매개변수의 지시 튜닝 모델이 100배 넘게 큰 GPT-3보다 사람들에게 더 선호되었습니다.
2017년 이전의 최고 언어 모델은 단어를 하나씩 읽는 순환 방식이었지만, 트랜스포머는 모든 위치를 동시에 처리해 GPU에서 병렬 계산이 가능하게 했습니다. 이후 모델은 크게 커졌고, 최근에는 전문가 혼합(MoE) 구조가 쓰입니다. 여러 작은 MLP인 전문가 가운데 라우터가 토큰마다 일부만 골라 계산하므로 전체 크기에 비해 계산량을 줄일 수 있습니다. 영상은 LLM 안에 데이터베이스가 따로 있지 않으며, 온도 0이라도 서버 환경에 따라 결과가 완전히 같지 않을 수 있다는 점도 짚습니다.


