요약
⏱ 00:021. 카드 예제로 보는 두 예측의 차이
⏱ 00:02여덟 장의 카드가 있고 A가 네 장, B가 두 장, C와 D가 각각 한 장씩 있다. 이 카드 묶음에서 무작위로 한 장을 뽑을 때, 두 가지 예측 모델이 서로 다른 확률을 내놓는다. 첫 번째 모델은 A에 더 큰 확률을 주고, 두 번째 모델은 B에 더 큰 확률을 준다. 어느 쪽이 더 나은 확률인지 판단하려면 실제로 나온 결과에 대해 각 모델이 얼마나 놀랐는지를 점수로 비교해야 한다.
⏱ 00:232. 로그로 확률을 벌점으로 바꾸기
⏱ 00:23확률을 벌점으로 바꾸는 방법으로 음의 밑 2 로그를 쓴다. 확률이 2분의 1이면 벌점은 1비트, 4분의 1이면 2비트, 8분의 1이면 3비트다. 즉 관측된 결과의 확률이 절반으로 줄 때마다 벌점은 1비트씩 늘어난다.
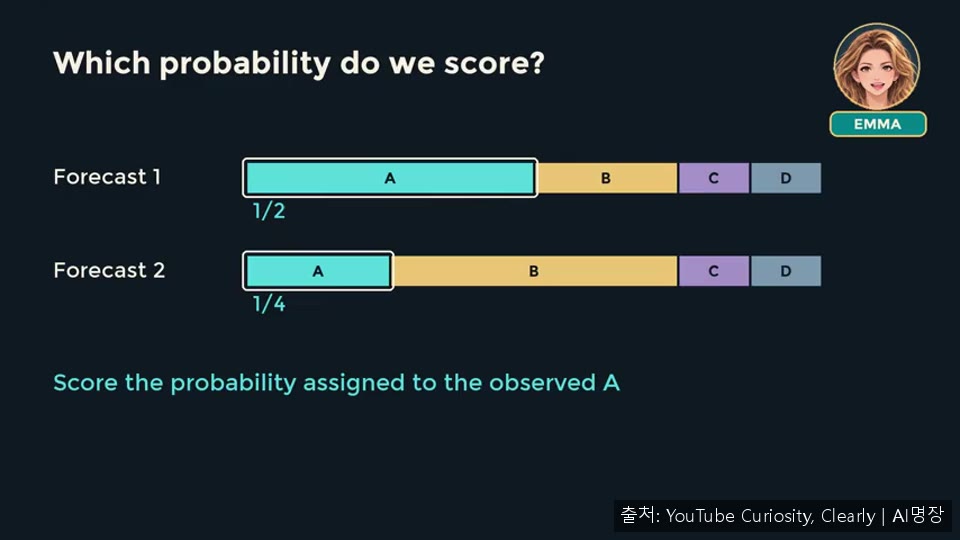
이 규칙을 첫 번째 모델에 적용하면 A 카드 네 장은 각각 1비트, B 카드 두 장은 각각 2비트, C와 D는 각각 3비트가 된다. 합계는 14비트이고 카드 여덟 장으로 나누면 카드 한 장당 평균은 1.75비트다. 두 번째 모델은 A와 B의 확률을 서로 바꾼 것이므로 A 카드 네 장의 벌점이 커지고 B 카드 두 장의 벌점만 줄어든다. 그 결과 총합은 16비트, 평균은 2비트가 되어 첫 번째 모델보다 나쁜 점수를 받는다.
⏱ 01:283. 교차 엔트로피와 KL 발산의 관계
⏱ 01:28관측된 분포를 P, 모델의 예측 분포를 Q라고 하자. P는 우리 자료에서 각 글자가 실제로 나타나는 빈도이고, Q는 모델이 각 글자에 부여한 확률이다. 카드마다 점수를 더하는 대신, 글자별 벌점에 그 글자가 차지하는 비율을 곱해서 더해도 같은 결과가 나온다. 이 가중 평균이 P에서 Q로 가는 교차 엔트로피다.
예측이 데이터 분포와 정확히 같다면 교차 엔트로피는 데이터 자체의 엔트로피가 된다. 이는 데이터가 가진 평균적인 놀라움의 크기로, 이 예에서는 1.75비트다. 두 번째 예측처럼 예측이 어긋나면 그보다 카드당 약 0.25비트가 추가로 든다. 이 추가분을 KL 발산이라 부른다. KL 발산은 두 분포가 일치할 때만 0이 되고 그 외에는 양수다. 개별 항은 음수가 될 수 있지만 전체 합은 음수가 되지 않는다는 점이 중요하다.
⏱ 03:174. 언어 모델 학습에 적용하기
⏱ 03:17문장 앞부분 'the sky is'를 주면 언어 모델은 다음에 올 토큰들의 확률을 제시한다. 토큰은 텍스트를 나눈 조각이다. 실제로 다음 토큰이 blue였다면, 모델이 blue에 4분의 1을 줬을 때 이 학습 예시의 벌점은 2비트이고, 2분의 1을 줬을 때는 1비트다. 관측된 토큰은 그대로 두고 예측만 바꿔 보면 손실이 어떻게 달라지는지 확인할 수 있다.
이 과정을 수많은 학습 위치에서 반복하고 벌점을 평균 내면 학습 손실이 된다. 학습은 이 손실을 줄이는 방향으로 모델의 내부 값을 조정한다. 자연로그를 쓰면 손실의 단위는 비트 대신 nat이 되지만, 어떤 모델이 더 나은지에 대한 순서는 그대로 유지된다.
⏱ 03:555. 정확도가 같아도 손실은 다를 수 있다
⏱ 03:55영상은 일부러 만든 네 개의 관측값 A, A, A, B를 예로 든다. 두 분류기는 항상 더 확률이 높은 글자를 고르는데, 첫 번째 모델은 A에 75퍼센트, 두 번째 모델은 99퍼센트를 준다. 둘 다 A를 고르므로 네 번 중 세 번 맞혀 정확도는 같은 75퍼센트다.
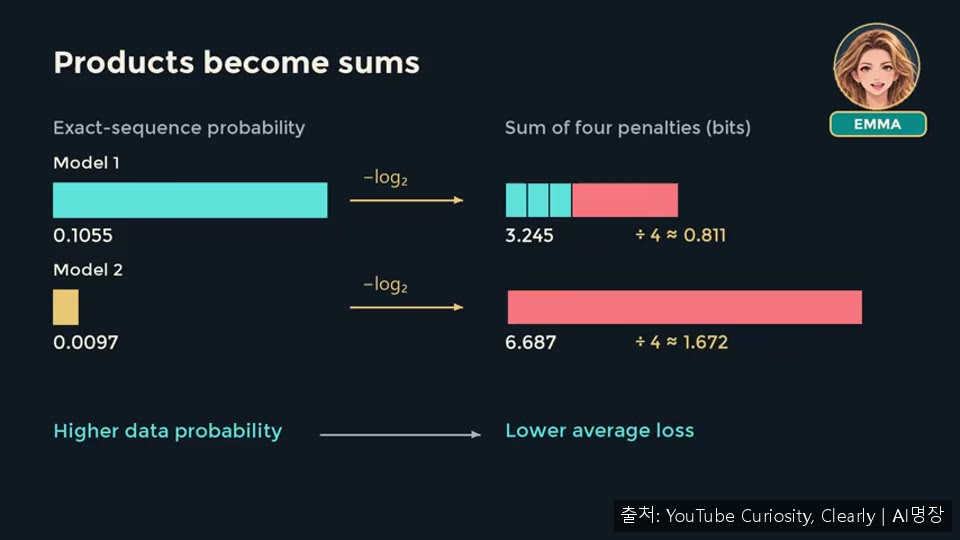
하지만 손실은 크게 다르다. A가 나온 세 번에서 첫 번째 모델은 각각 약 0.415비트, 두 번째 모델은 약 0.0145비트를 치른다. 확신에 찬 정답은 이 세 번에서 이득이 된다. 그러나 B가 나오자 두 번째 모델은 B에 1퍼센트만 남겨 두었기 때문에 약 6.64비트라는 큰 벌점을 받는다. 평균 손실은 첫 번째 모델이 약 0.81비트, 두 번째 모델이 약 1.67비트다. 한 번의 과신한 실수가 여러 번의 정답에서 얻은 이득을 뒤엎은 것이다. A에 주는 확률을 바꿔 보면 평균 손실은 데이터의 비율과 같은 4분의 3에서 최소가 된다.
⏱ 05:326. 확률의 곱과 로그 손실의 연결
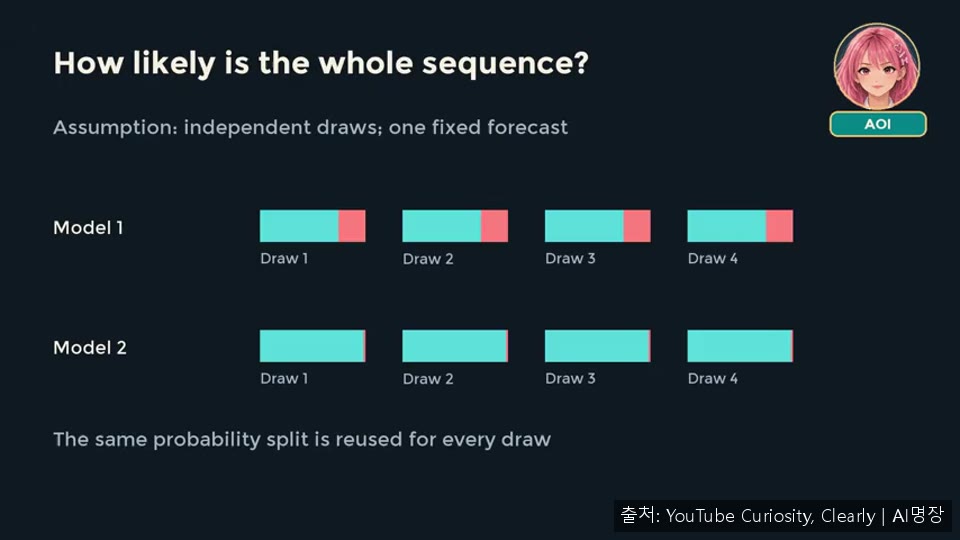
⏱ 05:32로그를 쓰지 않고도 같은 비교를 할 수 있다. 네 번의 뽑기가 서로 독립이고 각 뽑기에 같은 확률을 준다고 가정하면, 정확한 순서 A, A, A, B가 나올 확률은 확률들의 곱이다. 첫 번째 모델은 약 0.1055, 두 번째 모델은 약 0.0097이다. 첫 번째 모델이 관측된 순서에 더 높은 확률을 준다.
⏱ 06:207. 새로운 데이터에서의 평가와 마무리
⏱ 06:20네 개의 학습 예시에 맞추는 것만으로는 모델이 새로운 데이터에서 잘하는지 알 수 없다. 그래서 학습에 쓰지 않은 관측값으로도 손실을 계산한다. 실제 분류기에서는 입력마다 예측 확률이 달라지는데, 같은 채점 규칙을 각 예측과 그 예측의 실제 결과에 적용하면 된다. 실제로 일어난 일의 확률을 읽고, 벌점으로 바꾸고, 평균을 낸다. 이것이 엔트로피에서 학습 손실로 이어지는 다리다.
영상은 마지막으로 확률이 두 배가 되면 벌점이 어떻게 변하는지 댓글로 생각해 보라고 제안하며, 다음 편에서는 보정(calibration)을 다루겠다고 예고한다. 모델이 70퍼센트라고 말할 때 실제로 그 비율만큼 맞히는지를 묻는 주제다.