
요약
⏱ 00:001. LLM의 기본 원리: 다음 토큰 예측
⏱ 00:00ChatGPT, Claude, Gemini 같은 서비스의 바탕에는 거대 언어 모델(LLM)이라는 같은 종류의 기술이 있습니다. LLM이 하는 일은 기본적으로 하나로, 주어진 텍스트 다음에 올 내용을 예측하는 것입니다. 예를 들어 '프랑스의 수도는'이라고 입력하면 '파리'가 나올 확률이 높다고 계산하고, 그 단어를 텍스트에 붙인 뒤 예측을 반복합니다. 이렇게 단어가 하나씩 쌓여 긴 글이 완성됩니다.
⏱ 02:312. 트랜스포머와 어텐션, 출력 선택
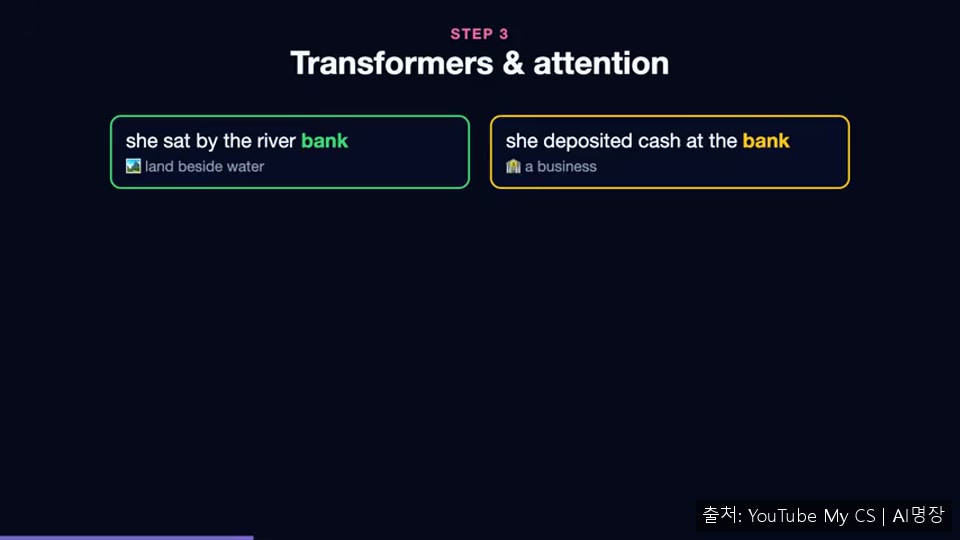
⏱ 02:31트랜스포머는 2017년 구글 연구진이 'Attention Is All You Need' 논문에서 소개한 구조이며, 핵심은 어텐션 기능입니다. 각 토큰이 문장 안의 다른 토큰 중 자신의 의미에 중요한 것을 찾아 집중하는 방식이며, 모든 토큰이 동시에 이 계산을 하므로 그래픽 칩에서 잘 작동합니다. 이런 층을 보통 100개 안팎으로 쌓아, 초반 층은 문법 같은 단순한 요소를, 뒤쪽 층은 반어 같은 추상적 개념을 다룹니다.
⏱ 04:203. 학습 과정: 사전 학습과 미세 조정
⏱ 04:20모델은 먼저 웹 사이트, 책, 코드, 기사 등 방대한 텍스트로 사전 학습을 합니다. 최신 모델은 수조 개 이상의 토큰을 읽으며, 다음 토큰을 가리고 추측하게 한 뒤 오차를 줄이도록 모든 파라미터를 조금씩 조정하는 과정을 수없이 반복합니다. 이 작업에는 수천 개의 그래픽 칩이 몇 주에서 몇 달 동안 필요하고 막대한 비용이 듭니다. 연구자들은 모델, 데이터, 컴퓨팅이 커질수록 성능이 예측 가능하게 좋아진다는 스케일링 법칙을 발견했고, 2022년 친칠라 연구는 파라미터당 약 20개의 학습 토큰이 필요하다는 경험적 규칙을 제시했습니다.
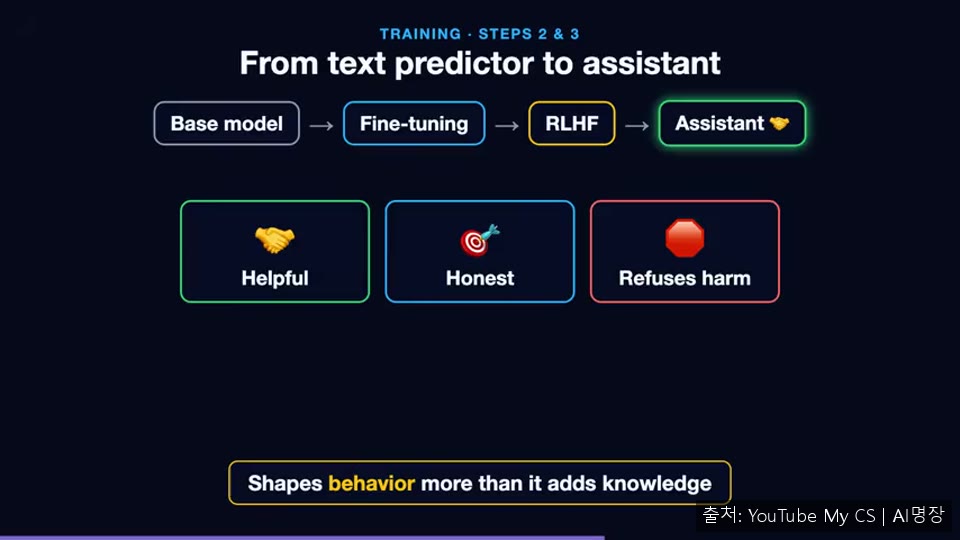
사전 학습이 끝난 기본 모델은 지식은 많지만 비서 역할은 하지 못해 질문을 퀴즈처럼 되받아칠 수도 있습니다. 그래서 유용하고 명확한 답변 예시로 미세 조정을 거치고, 사람이 두 답변 중 더 나은 쪽을 고른 데이터로 보상 모델을 만든 뒤 강화 학습을 하는 RLHF 단계를 거칩니다. 이 단계는 새 지식을 더하기보다 유용하고 정직하게 행동하며 해로운 요청을 거절하는 행동 양식을 형성하는 과정입니다.
⏱ 06:004. 컨텍스트 윈도우, 검색, 추론과 에이전트
⏱ 06:00모델이 한 번에 볼 수 있는 범위를 컨텍스트 윈도우라고 하며, 사용자 메시지, 답변, 붙여 넣은 문서가 모두 포함됩니다. 이 크기는 수천 토큰에서 수십만, 일부는 수백만 토큰까지 늘어나 책 몇 권 분량도 다룰 수 있습니다. 하지만 윈도우를 벗어난 내용은 기억하지 못하며, 앱이 따로 메모를 저장하지 않는 한 새 대화는 처음부터 시작됩니다. 최신 사건이나 개인 파일을 다루려면 관련 문서를 검색해 컨텍스트에 넣는 검색 증강 생성, 즉 RAG 기술을 씁니다.
최근 LLM을 바꾼 두 가지 업데이트는 추론 모델과 도구 사용입니다. 추론 모델은 바로 답하지 않고 단계별로 생각하며 결과를 검토하고 막히면 다른 방법을 시도해, 수학, 코딩, 논리 퍼즐에서 성능이 크게 향상됩니다. 도구 사용은 웹 검색, 계산기, 코드 실행기를 호출해 결과를 읽고 작업을 이어 가는 방식이며, 이를 반복하면 계획하고 행동하며 끝까지 수행하는 에이전트가 됩니다.
⏱ 07:505. 주요 한계와 오류
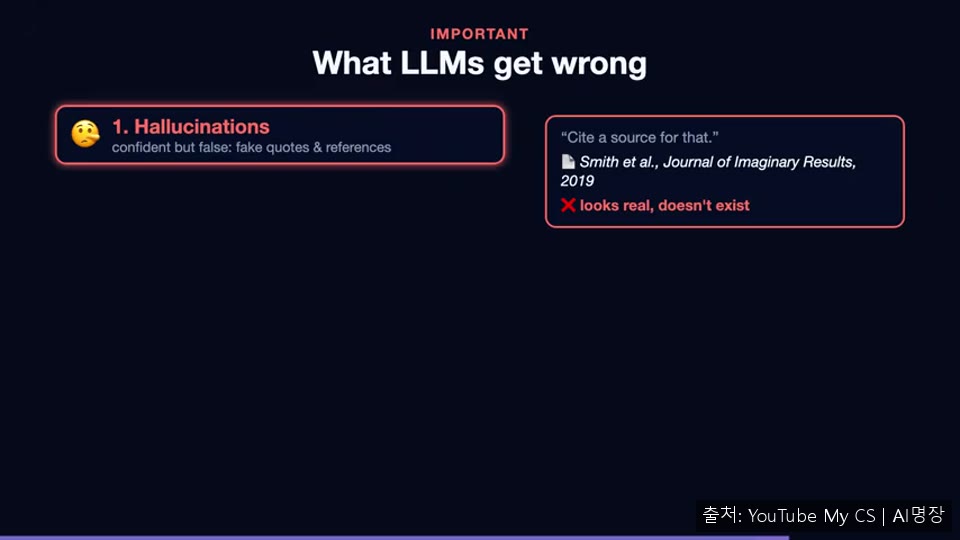
⏱ 07:50첫째는 환각입니다. 모델은 사실을 확인하는 것이 아니라 그럴듯한 텍스트를 예측하므로, 꾸며낸 인용이나 가짜 참고문헌을 확신 있게 말할 수 있습니다. 연구에서는 학습과 평가 과정이 모른다고 답하기보다 확신에 찬 추측을 더 높게 평가하는 경향이 있다고 지적됩니다. 둘째는 지식의 단절로, 검색 기능이 없으면 최신 뉴스를 모를 수 있습니다. 셋째는 편향으로, 인간의 글을 배웠기 때문에 고정관념을 반복할 수 있습니다.
넷째는 개인정보와 보안입니다. 통제할 수 없는 챗봇에 비밀번호나 민감한 데이터를 입력하지 말아야 하며, 웹 페이지나 문서에 숨겨진 지시문으로 AI 에이전트를 조작하려는 프롬프트 인젝션을 주의해야 합니다. 마지막으로 같은 질문에도 매번 다른 답이 나올 수 있어 일관성이 보장되지 않습니다.
⏱ 08:406. 효과적인 활용법과 정리
⏱ 08:40잘 활용하려면 질문을 구체적으로 하고, 맥락과 목표, 원하는 형식을 알려 주는 것이 좋습니다. 모델의 기억에 의존하기보다 원본 자료를 함께 붙여 넣는 것이 효과적입니다. 건강, 금융, 법률, 운영 환경에 배포할 코드처럼 중요한 내용은 신뢰할 수 있는 출처로 반드시 확인해야 합니다. 추론 과정을 보여 달라고 하거나 불확실한 부분을 나열하게 하면 도움이 되며, LLM은 매우 박식하지만 때로 당당하게 틀리는 조수로 대하고 최종 책임은 사용자에게 있다고 생각하는 것이 좋습니다.

정리하면 LLM은 다음 토큰을 예측하며, 텍스트는 토큰과 임베딩으로 바뀌어 트랜스포머의 어텐션 층을 거칩니다. 방대한 데이터로 사전 학습한 뒤 미세 조정과 인간 피드백으로 비서 형태가 되고, 검색, 도구, 추론으로 능력이 확장되지만 환각은 여전히 일어날 수 있습니다.


