요약
⏱ 00:001. 번역 모델이 범용 엔진이 되기까지
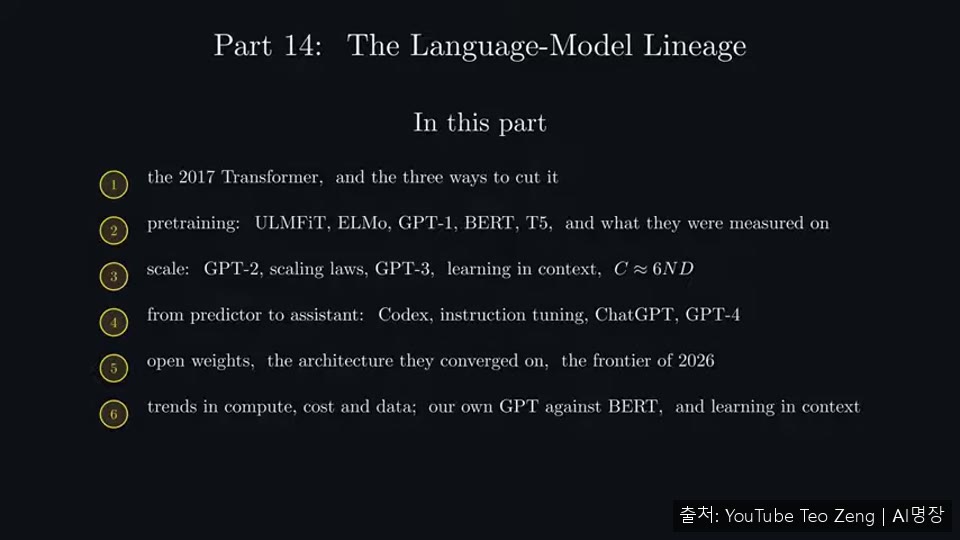
⏱ 00:002017년 구글 연구원들이 발표한 'Attention is all you need' 논문은 영어를 독일어와 프랑스어로 번역하는 모델을 제안했다. 번역을 위해 만들어진 이 구조가 챗GPT를 포함한 거의 모든 언어 AI의 기반이 된 과정이 이번 편의 주제다.
⏱ 02:132. 트랜스포머의 구조와 2017년 성과
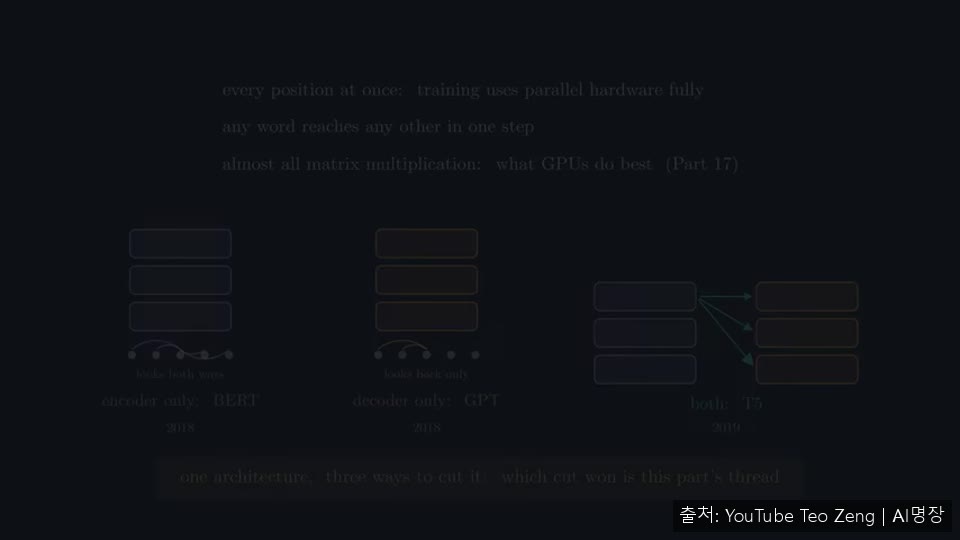
⏱ 02:132017년 당시 최고 번역기는 어텐션을 더한 순환 신경망이었는데, 단어를 순서대로 하나씩 읽어야 해서 훈련을 병렬화하기 어려웠다. 트랜스포머는 순환 구조를 없애고 모든 위치가 다른 모든 위치를 한 번에 참조하도록 만들었다.
⏱ 05:463. 사전 학습 후 미세 조정의 등장
⏱ 05:46레이블 데이터는 비싸고 원시 텍스트는 거의 공짜라는 점에서 출발한다. 2018년 ULMFiT는 위키피디아로 언어 모델을 사전 학습한 뒤 분류 작업에 맞춰 미세 조정해 오류를 크게 줄였다. ELMo는 문장 맥락에 따라 달라지는 단어 벡터를 만들어 같은 단어도 의미에 따라 다른 표현을 얻게 했다.
⏱ 08:514. BERT와 마스크 언어 모델
⏱ 08:512018년 10월 구글의 BERT는 인코더만 사용해 모든 위치에서 양방향 문맥을 보도록 설계되었다. 모든 것을 보는 모델은 다음 단어를 예측하도록 학습할 수 없으므로, 입력의 15%를 골라 그중 80%는 마스크로, 10%는 무작위 단어로 바꾸고 10%는 그대로 둔 뒤 원래 단어를 복구하게 했다.
⏱ 11:535. T5와 디코더 전용 설계의 부상
⏱ 11:532019년 10월 구글의 T5는 번역, 문법 판정, 유사도 점수, 요약까지 모든 작업을 텍스트 입력과 텍스트 출력으로 통일했다. 하나의 모델과 손실 함수, 디코딩 방식으로 비교한 결과, 스팬 손상 목표를 쓴 인코더-디코더가 GLUE에서 83.3점으로 1위를 차지했다. 다음 토큰만 예측한 디코더 전용 모델은 약 10점 뒤처졌다.
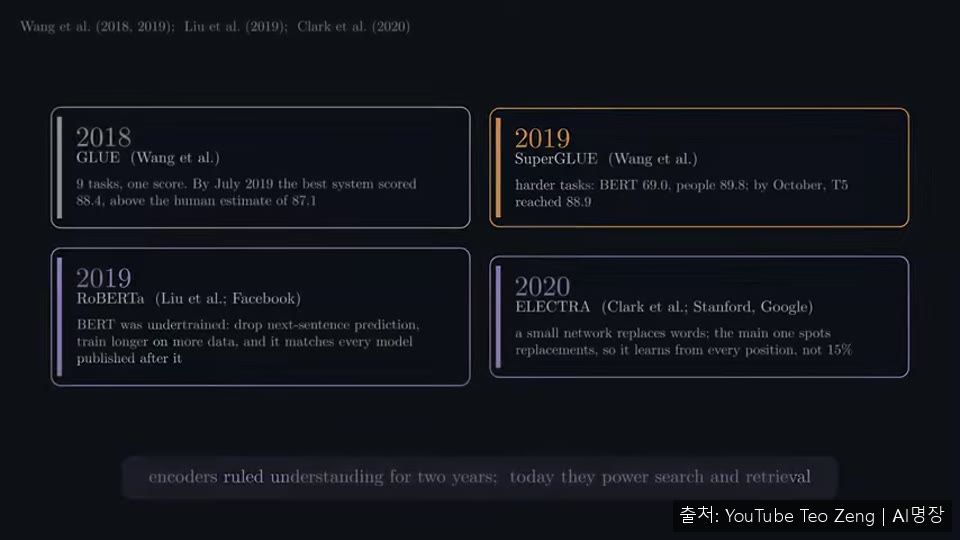
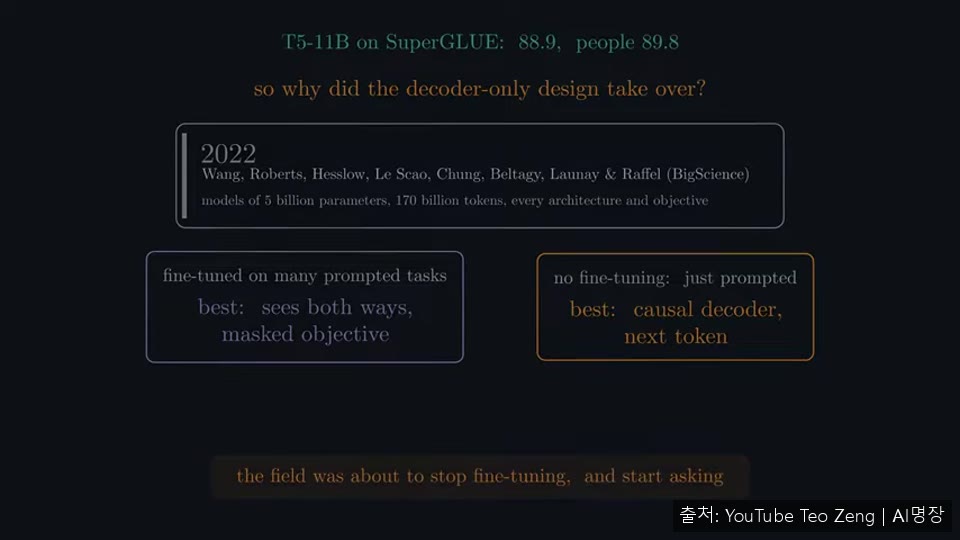
그럼에도 디코더 전용 설계가 주류가 된 이유는 2022년 비교 연구에서 드러난다. 미세 조정 후에는 마스킹 목표의 양방향 모델이 강했지만, 미세 조정 없이 프롬프트만 주었을 때는 인과적 디코더가 가장 뛰어났다. 작업마다 모델을 따로 조정하던 방식에서 하나의 모델에 말로 요청하는 방식으로 무게가 옮겨 가고 있었다는 신호다.
⏱ 14:286. GPT-2와 비지도 멀티태스킹
⏱ 14:282019년 2월 OpenAI의 GPT-2는 웹 링크에서 모은 약 40GB의 정제된 텍스트로 학습했고, 가장 큰 모델은 15억 개의 파라미터를 가졌다. 핵심 주장은 작업이 결국 텍스트 패턴이므로, 충분히 좋은 예측 모델은 프롬프트의 패턴을 이어 가며 작업을 수행한다는 것이다. 요약은 끝에 'TLDR'을 붙여 요청했고, 번역은 예시 몇 줄을 보여 주는 방식으로 요청했다.
추가 훈련 없이도 여러 벤치마크에서 성과를 냈고, 모델이 커질수록 성능이 꾸준히 좋아졌다. 오용 우려 때문에 공개는 단계적으로 진행되었고, 2019년 11월에야 전체 모델이 모델 카드와 함께 공개되었다. 이 논문이 남긴 교훈은 텍스트 예측만 학습한 하나의 모델이 여러 작업에 쓰일 수 있다는 점이었다.
⏱ 17:197. GPT-3의 규모와 문맥 내 학습
⏱ 17:192020년 5월 GPT-3는 1억 2,500만 개에서 1,750억 개 파라미터까지 여덟 가지 크기의 모델을 모두 3,000억 개 토큰으로 학습했다. 영상은 레이어별 행렬 크기를 더해 파라미터 수가 논문 부록의 1,746억 개와 맞는지 확인하고, 연산량도 6ND라는 근사식으로 계산해 3.14×10^23회라는 값을 재현한다. 이 근사식은 파라미터 수와 토큰 수에 비례해 연산이 늘어난다는 점을 보여 준다.
규모 법칙에 따르면 테스트 손실은 파라미터 수에 따라 멱법칙으로 감소했다. 가장 주목받은 발견은 문맥 내 학습으로, 작업 설명과 몇 개의 예시를 프롬프트에 넣으면 경사 하강 갱신 없이도 모델이 이어서 과제를 수행했다. 영상은 이 능력이 작은 규모에서도 나타나는지를 다음 실험의 질문으로 남긴다.