요약
⏱ 00:021. 카드 추첨으로 보는 불확실성
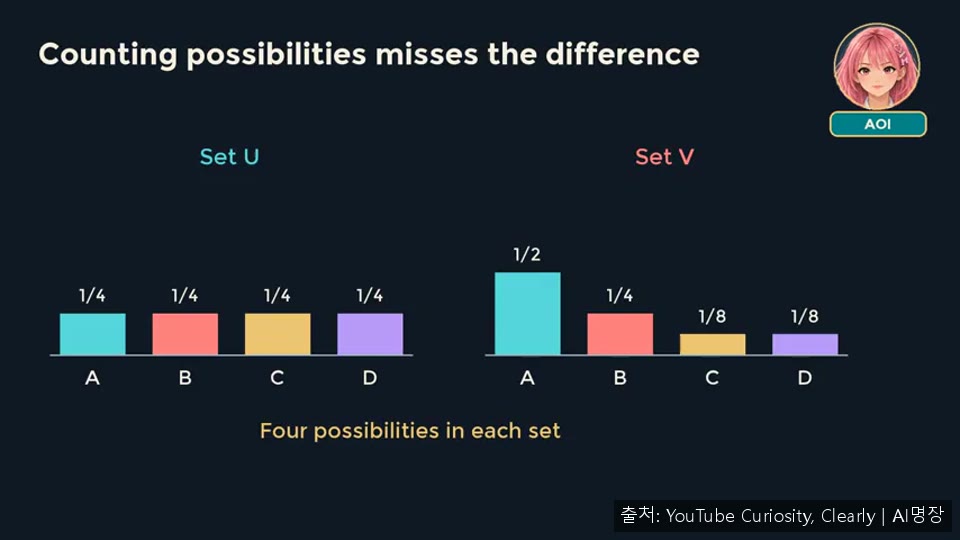
⏱ 00:02두 묶음의 카드 8장이 주어집니다. 첫 번째 묶음은 A, B, C, D가 각각 두 장씩이라 네 글자가 나올 확률이 모두 1/4입니다. 두 번째 묶음은 A가 네 장으로 많아 네 글자가 모두 가능하지만 A가 훨씬 자주 나옵니다.
가능한 글자의 개수는 같아도 어떤 글자가 얼마나 자주 나오는지에 따라 뽑기 결과의 예측 어려움이 달라집니다. 이 차이를 수로 재는 방법이 이 강의의 출발점입니다.
⏱ 00:432. 놀람값을 평균내는 발상
⏱ 00:43지난 강의에서 한 결과의 놀람값은 확률의 음의 로그로 정의했습니다. 확률이 1/2이면 1비트, 1/4이면 2비트, 1/8이면 3비트입니다. 이번에는 결과가 나오기 전에 가능한 모든 결과에 걸쳐 평균을 냅니다.
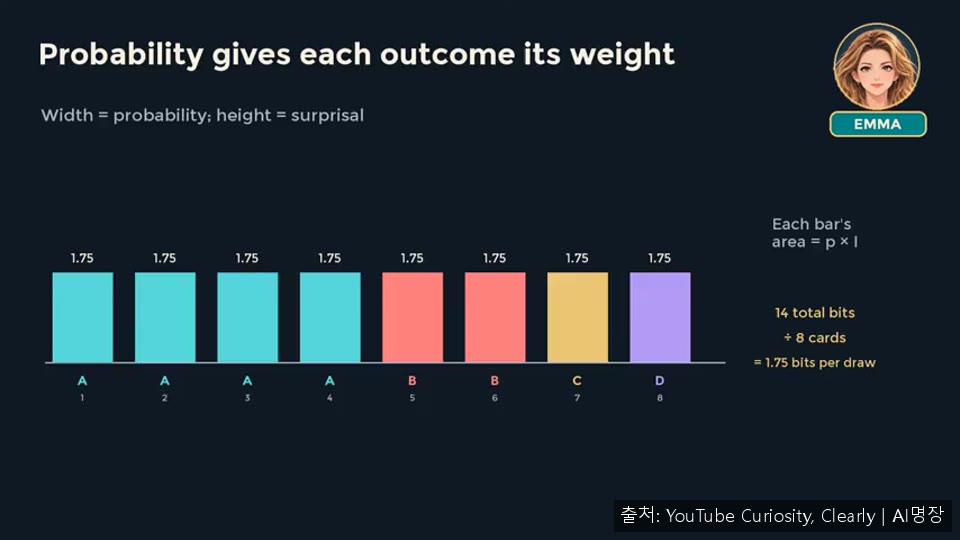
네 글자의 놀람값 1, 2, 3, 3을 단순히 더해 4로 나누면 2.25비트가 나옵니다. 하지만 이 방식은 A가 더 자주 나온다는 사실을 반영하지 못합니다. 각 글자의 놀람값을 그 글자가 적힌 카드마다 붙여 평균을 내면 8장 기준으로 1.75비트가 됩니다.
⏱ 02:013. 확률 가중 평균과 섀넌 엔트로피 공식
⏱ 02:01같은 값끼리 묶어 보면 각 결과의 확률에 놀람값을 곱해 모두 더하는 형태가 됩니다. 이 확률 가중 평균 놀람값이 섀넌 엔트로피이며 H(X)로 씁니다. 여기서 X는 뽑기 결과를 나타냅니다.
공식은 H(X) = -Σ p_i log2 p_i 입니다. 음의 부호 때문에 각 항이 0 이상이 되고, 로그의 밑을 2로 두었으므로 단위는 비트입니다. 엔트로피는 물리학의 엔트로피와 같은 수학적 꼴을 가지지만 해석과 단위는 다르며, 여기서는 특정 확률분포의 불확실성을 재는 값으로 쓰입니다.
⏱ 04:164. 최대값과 희귀 사건의 성질
⏱ 04:16결과가 N개이고 모두 같은 확률이면 엔트로피는 log2 N 비트가 되며, 이것이 가능한 최대값입니다. 두 결과 모델에서 앞면 확률을 0에서 1/2 사이로 움직여 보면 1/2일 때 1비트로 최대가 되고, 한쪽이 거의 확실해질수록 0에 가까워집니다.
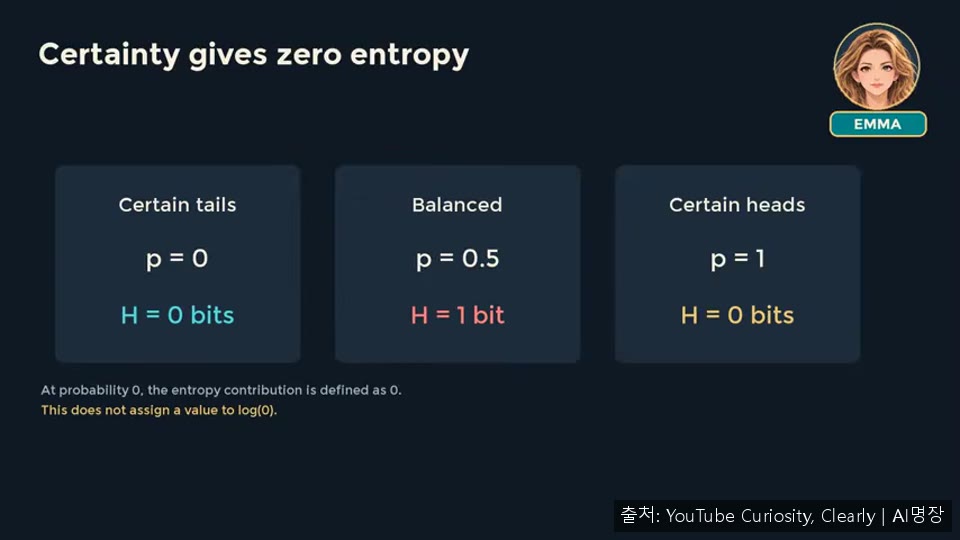
희귀한 결과는 나왔을 때 놀람값이 매우 크지만, 확률이 작아 평균에 기여하는 몫은 작습니다. 따라서 큰 놀람과 작은 평균 엔트로피가 함께 나타날 수 있습니다.
⏱ 06:345. 가변 길이 코드와 평균 비트 수
⏱ 06:34저장 단위는 0과 1이므로 1.75 같은 소수 평균은 얼핏 이해하기 어렵습니다. 이때 자주 나오는 글자에 짧은 코드를 주면 됩니다. A는 0, B는 10, C는 110, D는 111로 두면 어떤 코드도 다른 코드의 앞부분이 되지 않아 연속된 글자를 구분할 수 있습니다.
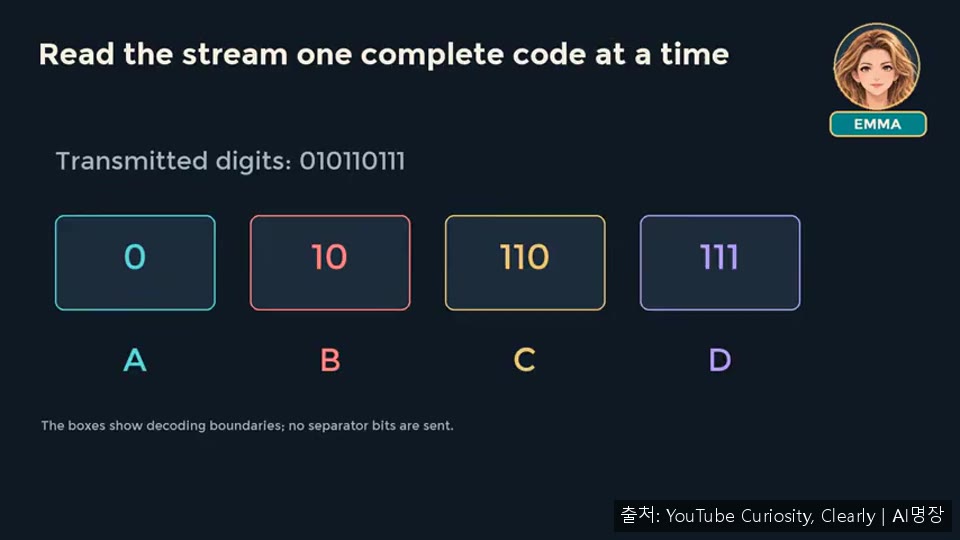
이 코드의 기대 길이는 1/2 x 1 + 1/4 x 2 + 1/8 x 3 + 1/8 x 3 = 1.75비트로 엔트로피와 정확히 일치합니다. 다만 이는 이 확률에 잘 맞는 특수한 경우이며, 일반적인 기호 하나의 코드가 항상 엔트로피에 정확히 닿는 것은 아닙니다. 독립적으로 반복되는 기호는 긴 블록을 묶어 평균 비트 수를 엔트로피에 가깝게 만들 수 있습니다.
⏱ 07:276. 언어모델의 다음 토큰 분포
⏱ 07:27언어모델은 앞의 문장을 보고 다음에 올 토큰의 확률을 줍니다. 이 강의는 파랑, 회색, 맑음, 어두움 네 개의 토큰만 있는 가상의 모델을 사용합니다. 실제 모델에서 측정한 값이 아니라 설명을 위한 가정입니다.
네 토큰이 모두 1/4이면 엔트로피는 2비트이고, 회색에 1/2을 주면 1.75비트로 줄어듭니다. 회색에 0.97을 주고 나머지 세 토큰에 0.01씩 주면 엔트로피는 약 0.242비트까지 떨어집니다.
⏱ 09:037. 엔트로피와 예측의 정확성은 다르다
⏱ 09:03엔트로피가 낮다고 예측이 좋다는 뜻은 아닙니다. 실제로 이어진 토큰이 파랑이었다면, 모델이 그 토큰에 준 확률 0.01의 놀람값은 약 6.64비트가 됩니다. 엔트로피는 모델 자신의 확률로 평균을 내고, 예측의 평가는 관측된 결과로 판단하기 때문입니다.