요약
1,000통 스팸 예시로 사전확률 10%가 'prize' 단서를 거쳐 사후확률 50%로 갱신되는 과정을 세기, 면적, 공식의 세 방식으로 보여준다. 분모가 바뀌는 이유, 우도와 정규화의 역할, 나이브 베이즈의 독립 가정과 중복 정보의 한계를 함께 짚는다.
⏱ 00:021. 자연 빈도로 세기
⏱ 00:02강의는 이메일 예시로 베이즈 정리를 세기, 그림, 수식의 순서로 쌓아 간다. 가정한 상황은 전체 1,000통 중 스팸 100통, 일반 메일 900통이며, 실제 수신함 측정치가 아니라 설명용 숫자라고 명시한다.
단서를 보기 전 메시지를 무작위로 하나 고르면 스팸일 확률은 100/1000, 즉 10%다. 이것이 단서를 쓰기 전의 출발 추정치인 사전확률(prior)이다.
⏱ 00:492. 단서 'prize'를 더하면
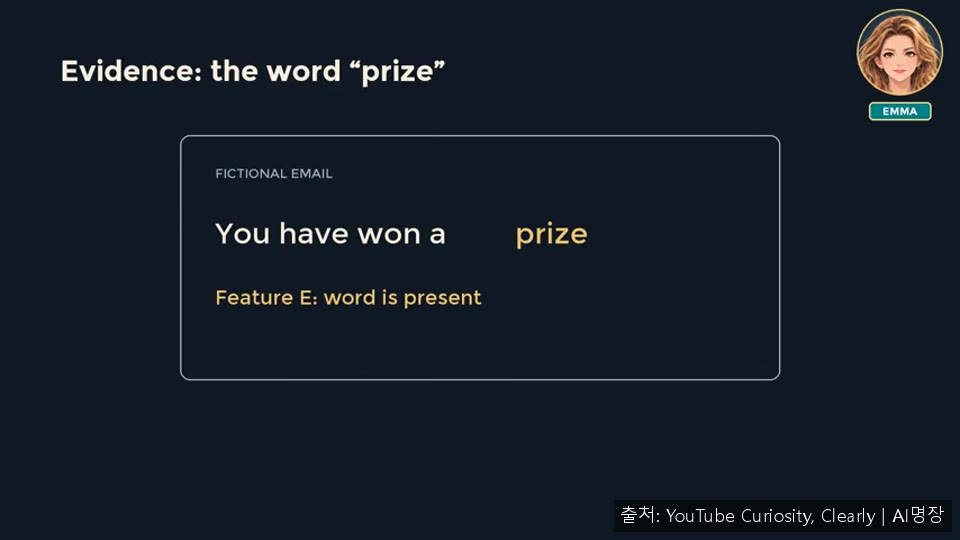
⏱ 00:49메시지에 'prize'라는 단어가 있다는 관찰이 추가되면 추정이 바뀐다. 스팸의 90%에 이 단어가 들어 있다고 가정하면 스팸 중 90통이 표시된다. 일반 메일의 10%에도 이 단어가 있어 90통이 걸린다.
⏱ 02:173. 90%가 아니라 50%인 이유
⏱ 02:17처음 질문은 스팸 100통을 기준으로 보면 된다. 그중 90통이 단어를 포함하므로 90%이고, 이는 스팸 안에서의 비율일 뿐이다. 'prize' 메시지 전체에 대한 스팸 확률로 이 값을 쓰면 일반 메일 속 같은 단어의 메시지를 빠뜨리는 실수가 된다.
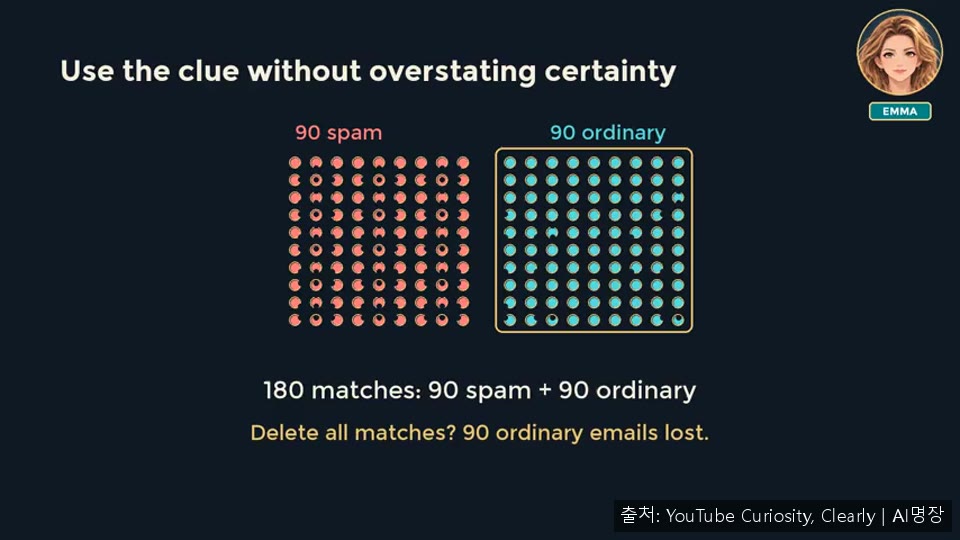
두 번째 질문은 단서가 붙은 메시지 전체를 기준으로 본다. 같은 스팸 90통은 이제 180통짜리 집합 안에 들어가므로 분모가 커지고, 그래서 답이 50%가 된다. 같은 메시지라도 어떤 집합을 기준으로 삼느냐에 따라 답이 달라진다는 점이 핵심이다.
⏱ 03:084. 면적으로 그리기
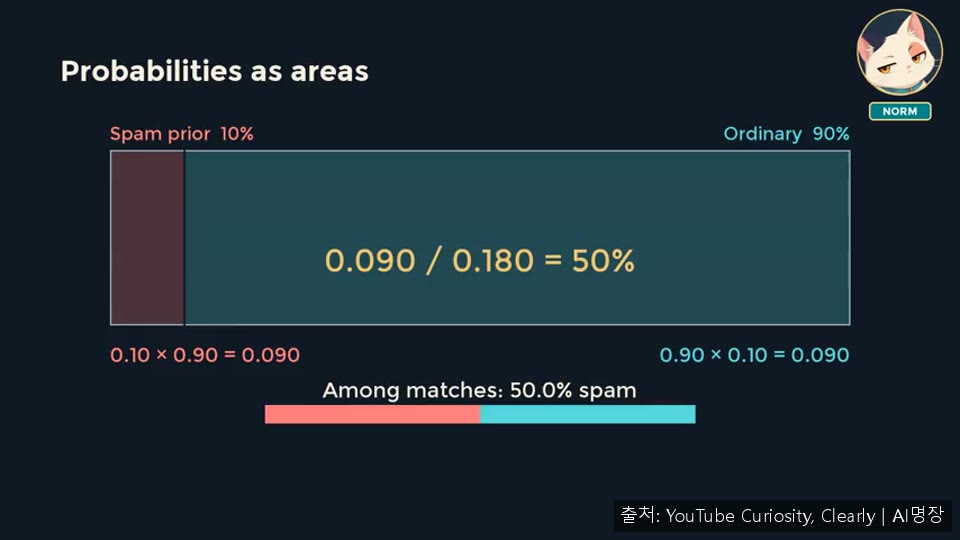
⏱ 03:08같은 비율을 면적으로 옮기면 직관이 쉬워진다. 전체 메시지를 넓이 1인 직사각형으로 보고, 가로 폭은 범주의 비중, 세로 높이는 범주 안에서 단서가 나타나는 비율로 나타낸다.
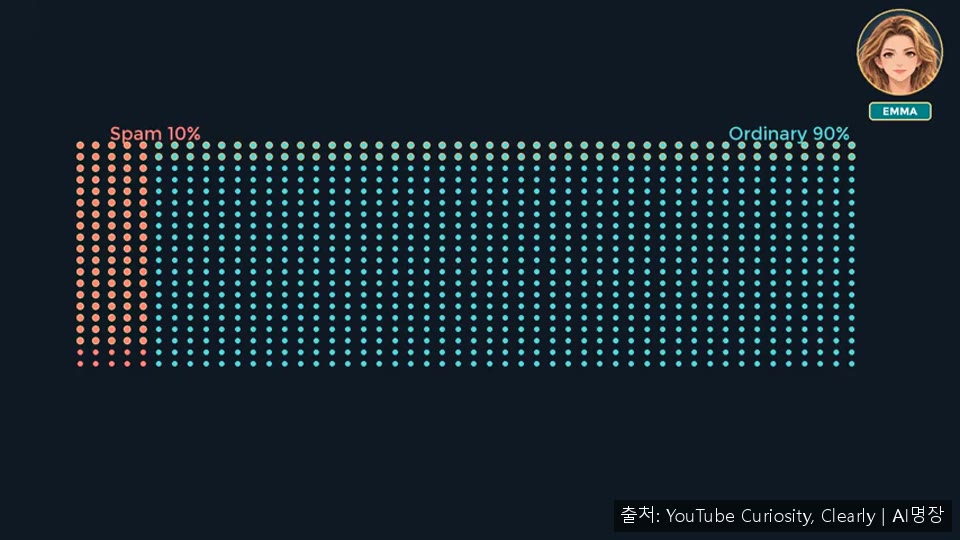
스팸은 폭 0.1에 높이 0.9를 곱해 0.09가 남고, 일반 메일은 폭 0.9에 높이 0.1을 곱해 역시 0.09가 남는다. 남은 면적 합 0.18 중 스팸 0.09가 차지하는 비율이 1/2, 즉 50%다. 단위만 바뀌었을 뿐 결과는 같다.
⏱ 04:075. 베이즈 정리 공식
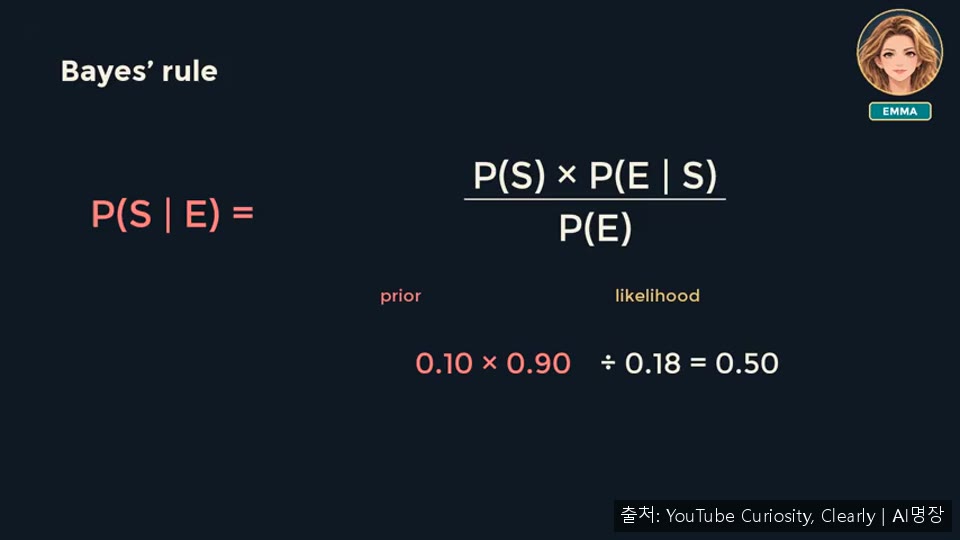
⏱ 04:07강의는 기호를 정리한다. S는 스팸, E는 증거인 'prize 포함'이며, P(S|E)는 증거를 관찰한 뒤의 스팸 확률인 사후확률이다. P(E|S)는 스팸일 때 이 증거가 나타날 가능성, 즉 우도(likelihood)다.
사전확률에 우도를 곱해 스팸 쪽 일치 면적을 얻고, 이를 증거 전체 확률 P(E)로 나누면 전체 일치 중 비중이 된다. 분모를 맞추는 이 과정을 정규화라 하며, 스팸과 일반 메일 두 범주가 모두 단서를 만들 수 있으므로 분모에는 둘 다 포함된다.
⏱ 05:016. 사전확률을 바꾸면
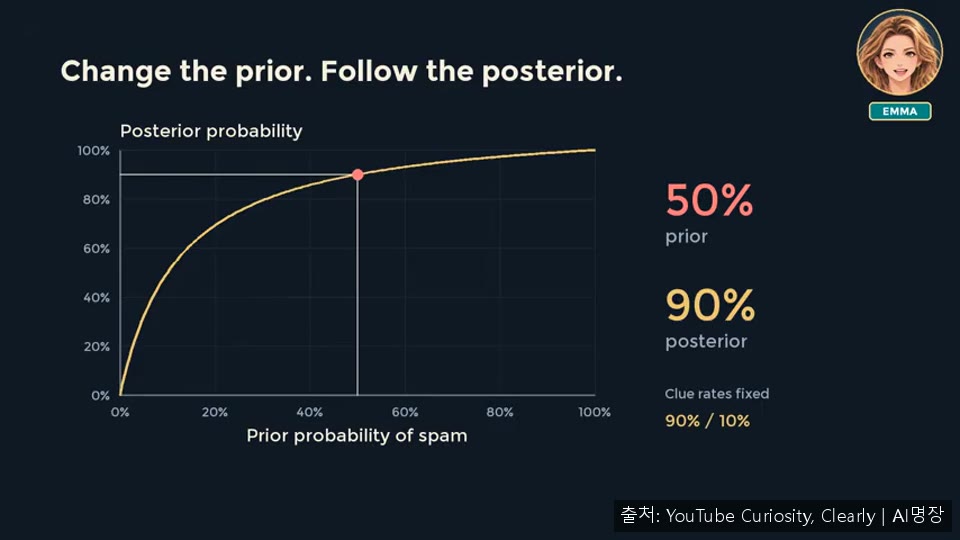
⏱ 05:01스팸 비율을 500통씩으로 바꾸고 단서 발생률은 그대로 두면 스팸 일치 450통, 일반 일치 50통이 되어 사후확률은 90%가 된다. 같은 단어라도 항상 같은 확률을 뜻하지 않는다는 뜻이다.
사후확률은 사전확률과 증거 모델 둘 다에 의존한다. 단서의 의미는 두 범주 중 한쪽에서 더 자주 나타나는지에 있으며, 두 범주에서 같은 비율로 나타나면 비율은 바뀌지 않는다.
⏱ 06:017. 나이브 베이즈와 중복 정보
그러나 prize와 winner처럼 관련된 단어는 정보가 겹칠 수 있어, 같은 정보를 두 번 세면 독립 단서가 되지 않는다. 또 계산된 확률이 자동으로 믿을 만한 신뢰도가 되는 것은 아니므로 데이터와 가정, 들어오는 메시지의 변화를 점검해야 한다.