요약
⏱ 00:001. 도입: 강화 학습과 양자 컴퓨터
⏱ 00:00발표는 신경망을 고양이와 개를 구별하는 데이터 피팅 방식의 학습에서 벗어나, 행동의 결과를 보며 배우는 강화 학습 패러다임을 소개하며 시작한다. 진행자는 2022년 ChatGPT 논문에서 인간 피드백 기반 강화 학습이 핵심 돌파구였다는 점을 예로 든다.
⏱ 00:572. 비트와 고전 오류 정정
⏱ 00:57양자 정보를 보호하려면 먼저 정보를 비트 단위로 표현한다는 개념을 짚는다. 비트는 더 나눌 수 없는 최소 정보 단위이며, 고전 트랜지스터는 전압으로 0과 1을 구분해 비트 반전 확률이 극히 낮다.
그러나 보이저호처럼 먼 거리의 통신에서는 신호가 노이즈에 묻히므로, 중복 인코딩으로 오류를 허용하는 오류 정정 코드가 필수다. 가장 단순한 예는 같은 메시지를 여러 번 반복하는 반복 코드(repetition code)이며, 보손 코드에서는 조화 진동자의 많은 에너지 준위가 그 중복성을 제공한다.
⏱ 03:173. 보손 코드와 이항 코드
⏱ 03:17진동자의 에너지 준위 중 0번과 1번을 큐비트로 쓰는 것이 가장 간단한 인코딩이지만, 이것만으로는 광자 손실 같은 오류를 감지할 수 없다. 이를 해결하기 위해 제시된 것이 이항 코드(binomial code)로, 2번 준위를 기준으로 0번과 4번의 중첩을 논리 상태로 정의한다.
이 상태들은 서로 직교하며, 광자 하나를 잃으면 준위가 이동하지만 광자 수의 패리티를 측정해 오류 발생 여부를 알아낼 수 있다. 평균 광자 수를 같게 맞추는 이유는 상태 간 손실 속도 차이로 생기는 편향을 막기 위해서이며, 코드 거리는 얼마나 많은 오류를 견딜 수 있는지를 나타내는 지표로 설명된다.
⏱ 07:144. GKP 코드
⏱ 07:14GKP 코드는 Gottesman, Kitaev, Preskill이 2001년에 제안한 보손 코드로, 위상 공간의 격자 구조를 이용한다. 양자 파동 함수를 위치 표현으로 보면 상태가 델타 함수의 격자처럼 나타나며, 작은 변위 오류가 격자 주기보다 작다면 다시 밀어 올바른 위치로 되돌려 수정할 수 있다.
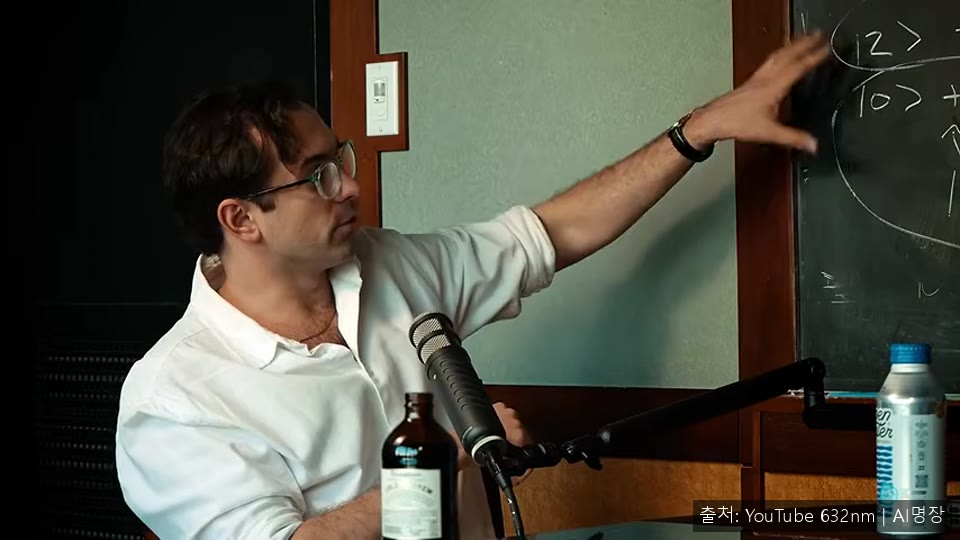
수정은 광자 수의 패리티 측정을 안정화 장치처럼 사용해, 논리 정보를 붕괴시키지 않고 오류 정보만 얻는 방식으로 이뤄진다. 다만 이 기본 구성은 두 광자 손실 같은 드문 오류에는 취약하며, 더 복잡한 코드로 확장할 수 있다고 설명된다.
⏱ 09:295. 게이트 보정과 펄스 설계
⏱ 09:29이론가가 회로에 그리는 게이트를 실제 큐비트에서 구현하려면 정밀하게 제어된 파형을 전송선으로 보내야 하며, 이 파형을 보정하는 일은 매우 어렵다. 사각 펄스는 모서리가 날카로워 스펙트럼이 넓기 때문에, 보통 가우시안이나 코사인 형태의 부드러운 엔벨로프를 쓰고 진폭, 주파수, 디튜닝을 조정한다.
상온 DAC에서 보낸 펄스는 케이블 반사 등으로 냉각 단계의 큐비트에 도착할 때 왜곡되므로, 미리 왜곡을 주어 하류의 변형을 상쇄하는 보정이 필요하다. 가장 단순한 경우 진폭과 위상 두 자유도로 시작하지만, 실제로는 약 10개 정도의 조정 요소가 필요하다고 설명된다.
⏱ 14:516. 2큐비트 게이트와 누설 제거
⏱ 14:512큐비트 게이트는 각 큐비트와 커플러에 펄스를 동시에 보내 강한 상호작용을 켜는 방식으로 수행된다. 구글의 큐비트는 자속 조절로 주파수를 이동시켜 게이트를 구현하며, 커플러는 게이트를 하지 않을 때 상호작용을 차단하는 역할을 한다.
표면 코드의 오류 정정 주기는 단일 큐비트 게이트, CZ 게이트, 측정, 재설정으로 이루어진다. 이때 큐비트가 계산 공간 밖의 높은 에너지 준위로 새는 누설(leakage)이 문제가 되는데, 측정 큐비트는 판독 공진기와 공명시켜 빠르게 리셋하고, 얽힘을 보존해야 하는 데이터 큐비트는 측정 큐비트로 스왑하는 특수 누설 제거 게이트로 처리한다.
⏱ 19:107. 잡음 이해와 폐루프 최적화의 전망
⏱ 19:10예일대의 break-even 실험에서는 게이트를 개별적으로 보정했음에도 오류 정정이 기대만큼 되지 않아, 실험 성능 신호로 매개 변수를 조정하는 폐루프 최적화를 도입했다. 충실도가 높아질수록 이전에는 노이즈 플로어 아래에 숨어 있던 드문 오류 채널이 드러나 모델링이 점점 어려워진다는 점도 논의된다.