요약
⏱ 00:001. 발표 소개와 연구 배경
⏱ 00:00진행자가 게스트를 소개하고, 엔비디아 리서치의 강화학습 팀이 어떤 연구 주제를 다루는지 간단히 설명합니다. 이어서 발표자의 연구가 최적의 정책을 얻는 일반적 접근과 어떻게 다른지 질문하며 대화를 시작합니다.
발표자는 정책 자체보다 최상의 결과물을 얻는 것이 목표라는 관점의 전환을 확인해 줍니다. 결과물만 필요하다면 학습에 쓴 모델은 나중에 버려도 된다는 점이 핵심으로 제시됩니다.
⏱ 03:432. 발견 문제와 TTT Discover 개요
⏱ 03:43발표자는 답을 모르는 미해결 문제를 어떻게 풀 것인지라는 질문으로 시작합니다. 커널 속도 향상이나 새로운 수학적 구조 발견처럼 정답이 정해지지 않은 문제가 대상이며, 공개 모델을 사용해 문제당 비교적 적은 비용으로 실험할 수 있다고 설명합니다.
발표자는 이전 연구인 TextGrad와 과학 에이전트 컨퍼런스, 아인슈타인 아레나 플랫폼을 차례로 소개합니다. 이런 흐름이 모여 TTT Discover라는 방법이 되었다고 정리합니다.
⏱ 09:003. 발견의 정의와 단순 샘플링의 한계
⏱ 09:00발견은 어떤 상태에서 출발해 그 상태의 특정 속성을 개선하려는 시도라고 정의됩니다. 예로 든 것은 기준 커널을 더 빠르게 만드는 일과, 수학적 구성에서 하한이나 상한을 개선하는 일입니다.
가장 단순한 방법은 많은 후보를 샘플링해 가장 좋은 것을 고르는 best of N입니다. 이 방식은 잘 작동하지만, 인간 최고 기록과 비교하면 여전히 큰 격차가 있었다고 발표자는 지적합니다.
⏱ 13:004. 테스트 시점 강화학습의 발상
⏱ 13:00발표자는 어려운 문제는 한 번에 풀리지 않으며, 시도하고 실패하며 문제의 성질을 익히는 과정이 필요하다고 말합니다. 교과서 문제를 풀 때 배우는 과정과 비슷하다는 비유입니다.
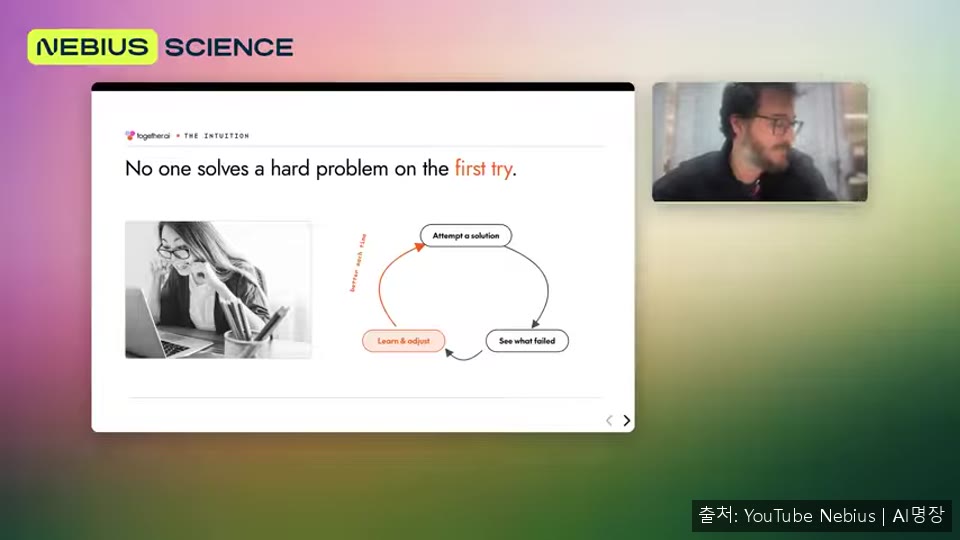
일반적인 강화학습은 평균 보상을 높이는 방향이므로 발견 문제에는 맞지 않을 수 있습니다. 그래서 테스트 시점에 한 문제에만 집중해 학습하고, 평균이 아닌 최선의 결과를 목표로 최적화한다는 구조가 제시됩니다.
⏱ 16:305. 방법의 구조: 베타 가중치와 상태 트리
⏱ 16:30방법은 샘플을 생성하고 보상을 계산한 뒤 모델을 갱신하며, 개선된 상태에서 다시 시작하는 반복 구조입니다. 이 과정에서 몬테카를로 트리 탐색에서 영감을 받은 상태 트리를 만들어 유망한 상태를 선택하고 재사용합니다.
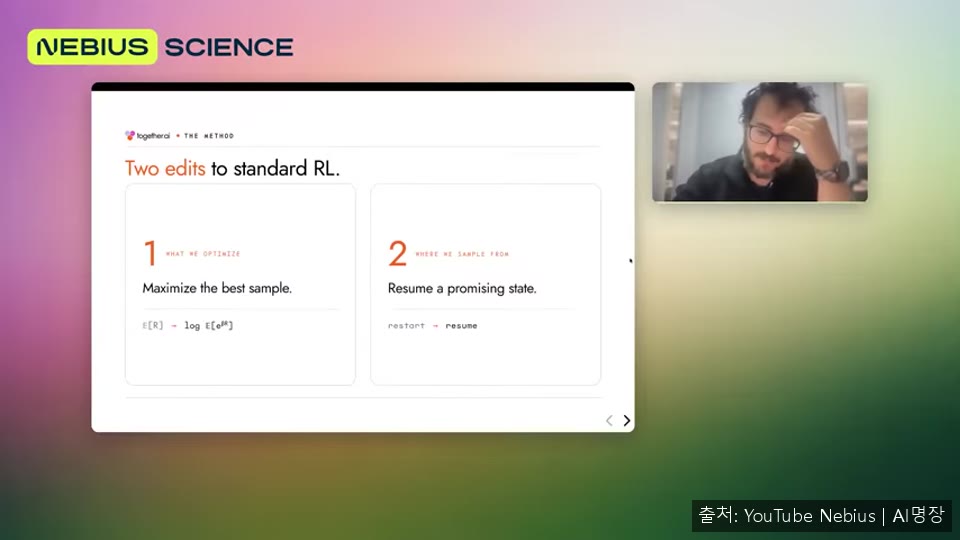
핵심 변화는 기대 보상을 최대화하는 대신 베타 파라미터로 최상의 롤아웃에 더 많은 가중치를 주는 방식입니다. 베타를 높이면 좋은 결과 쪽으로 학습이 기울고, 분포가 왜곡되지 않도록 학습 중에 실시간으로 조정한다고 설명합니다.
⏱ 19:006. 분야별 실험 결과
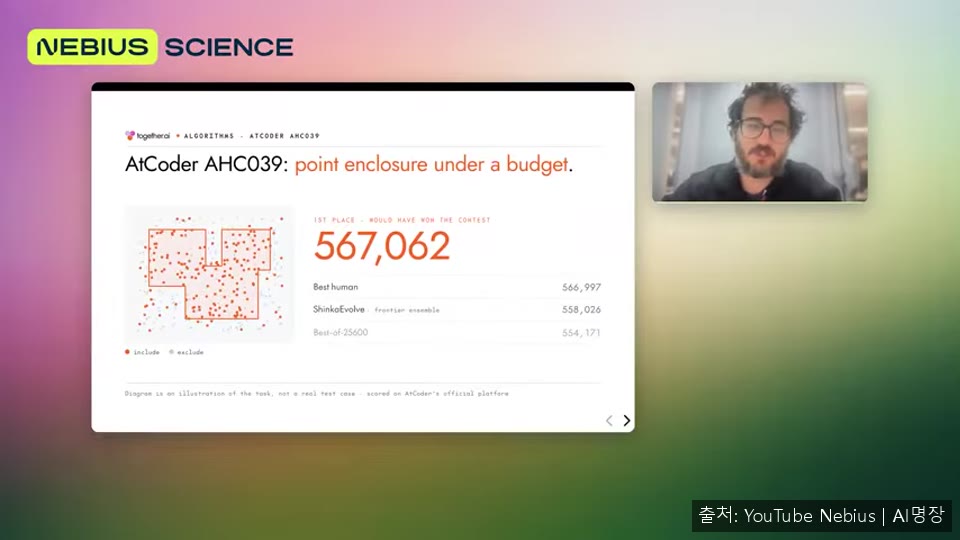
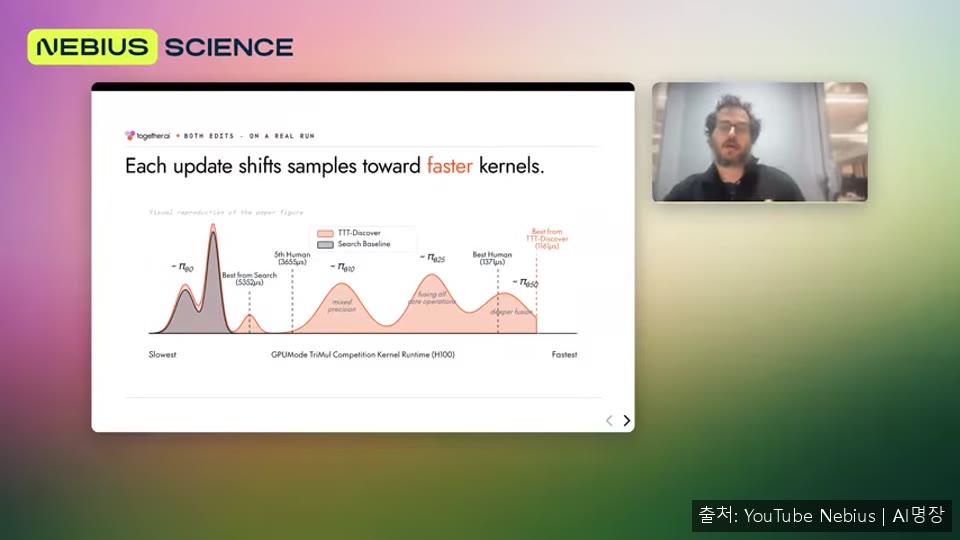
⏱ 19:00같은 파이프라인으로 GPU 커널, 수학적 구성, 알고리즘, 생물학 등 네 가지 작업을 수행했습니다. 학습 단계가 진행될수록 혼합 정밀도, 협업, 더 깊은 융합 같은 기법을 스스로 익히며 성능이 올라갔다고 소개합니다.
⏱ 21:307. 검증 방식과 마무리 흐름
⏱ 21:30실험 결과는 각 분야 전문가에게 보내 검토를 받았다고 설명합니다. GPU 커널은 GPU 모드 커뮤니티의 담당자에게, 수학 결과는 수학자에게, 생물학 결과는 해당 분야 교수에게 확인을 요청했습니다.