요약
⏱ 00:011. 강의 개요와 멀티모달의 동기
⏱ 00:01이번 강의는 고급 AI 과정에서 지각(perception) 파트를 마무리하는 시간으로, 지금까지 다룬 음성, 텍스트, 이미지 처리를 하나로 묶는 주제를 다룬다. 사람은 한 가지 감각에만 의존하지 않는다. 시끄러운 파티에서 대화 상대의 입술 움직임을 함께 보며 소리를 알아듣는 칵테일 파티 효과가 대표적인 예다.
같은 원리를 AI에 적용하면 한 모달리티의 정보가 불완전할 때 다른 모달리티로 보완해 더 견고한 시스템을 만들 수 있다. 다만 여러 입력을 합치면 정렬과 표현의 차이로 새로운 어려움도 생기므로, 강의는 이점과 과제를 함께 살핀다.
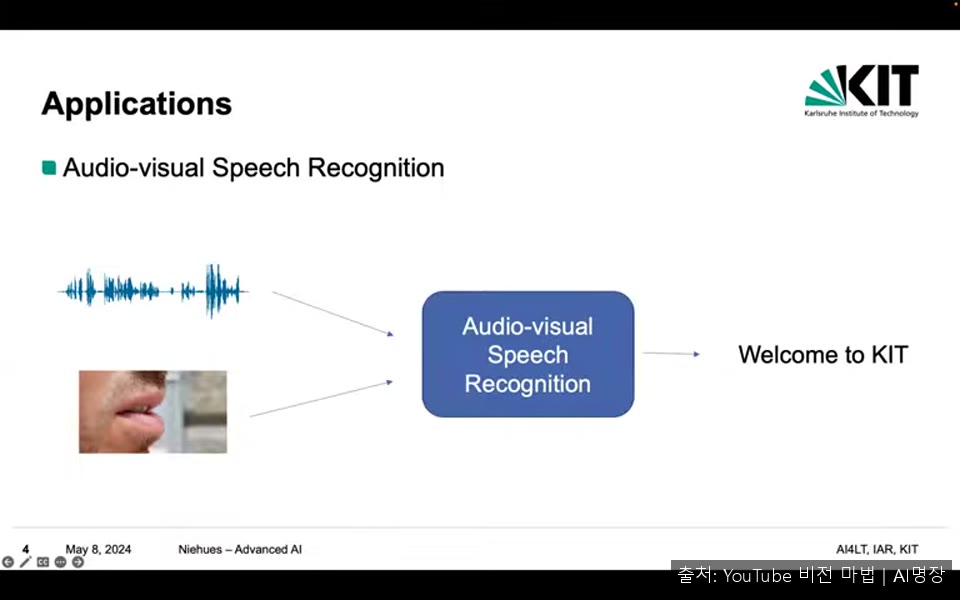
⏱ 03:002. 오디오-비주얼 음성인식
⏱ 03:00소음이 심한 환경에서는 음성 신호만으로 목소리를 정확히 뽑아내기 어렵다. 이때 말하는 사람의 입 모양 영상을 함께 쓰면 두 정보를 결합해 인식 성능과 견고성을 높일 수 있다. 또한 누가 말하고 있는지 식별하는 데도 도움이 된다.
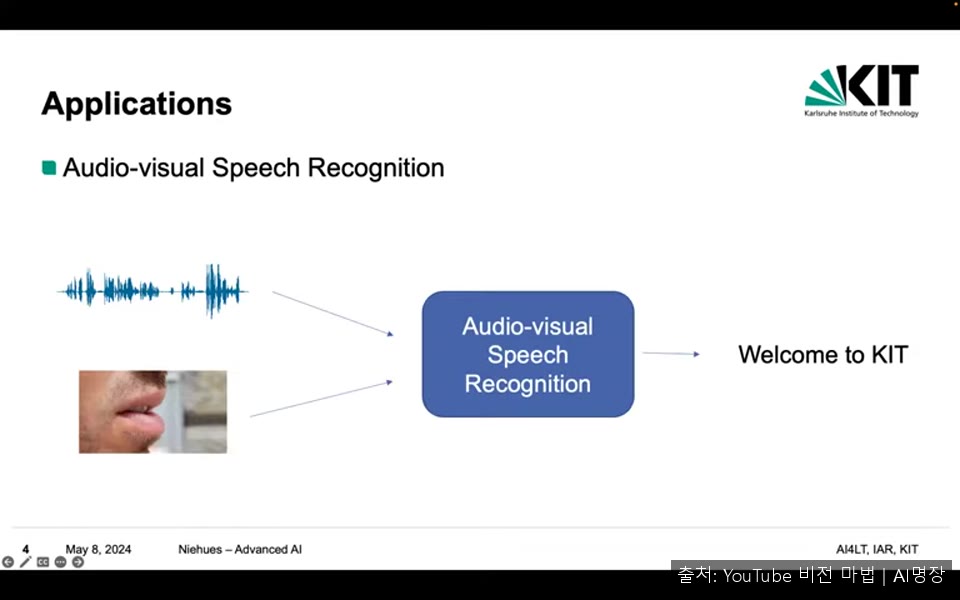
이 방식은 음성 처리 기술과 영상, 이미지 처리 기술을 모두 알아야 구현할 수 있다. 각 모달리티에서 얻은 특징을 적절히 합쳐 최종 인식에 활용하는 것이 핵심이다.
⏱ 04:143. 감정 인식과 시각 질의응답
⏱ 04:14다중모달 감정 인식은 영상 속 사람이 기쁜지 화가 났는지 판단하는 과제다. 목소리만으로는 감정을 추정하기 어려운 경우가 많고, 표정과 자세 같은 시각 정보가 더해지면 판단이 훨씬 정확해진다.
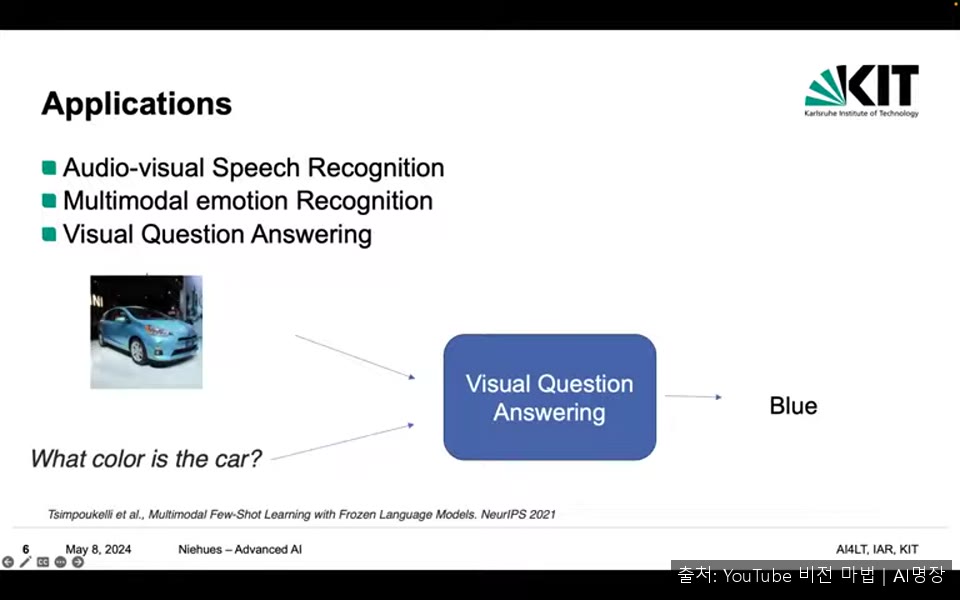
시각 질의응답(visual question answering)은 텍스트 질문에 이미지를 보고 답하는 과제다. 예를 들어 자동차 색깔을 묻는 질문은 텍스트만으로는 풀 수 없고 이미지가 반드시 필요하다. 강의는 이를 두 가지 관계로 나눈다. 오디오-비주얼 인식처럼 정보가 겹치는 중복형은 한쪽이 없어도 풀 수 있지만 결합하면 견고해진다. 반면 질의응답처럼 정보가 서로 보완하는 상보형은 두 모달리티가 모두 있어야 정답에 도달할 수 있다.
⏱ 07:154. 멀티모달 대화 시스템
⏱ 07:15마지막으로 최근 가장 주목받는 분야로 멀티모달 대화 시스템이 소개된다. 기존 대규모 언어 모델은 텍스트 중심이었지만, 이후 모델들은 이미지를 함께 이해하고 답할 수 있게 발전했다. 강의에서는 GPT-4가 텍스트뿐 아니라 이미지도 이해하게 된 점을 큰 도약으로 언급한다.
예시로 이미지 속 그림이 무엇이 웃긴지 설명하거나 패널을 하나씩 묘사하는 작업이 제시된다. 이런 과제는 이미지 내용을 어느 정도 이해하는 능력과 텍스트를 해석하는 능력을 함께 요구하며, 두 정보를 결합해 답을 생성하는 과정이 필요하다.
⏱ 11:155. 모달리티의 종류와 원시·추상 구분
⏱ 11:15모달리티는 입력 정보의 종류를 뜻하며, 가장 흔한 세 가지는 텍스트, 음성, 시각 정보다. 로봇 응용에서는 촉각이, 의료 분야에서는 생체 신호와 다양한 센서 데이터가 추가 모달리티가 될 수 있다.
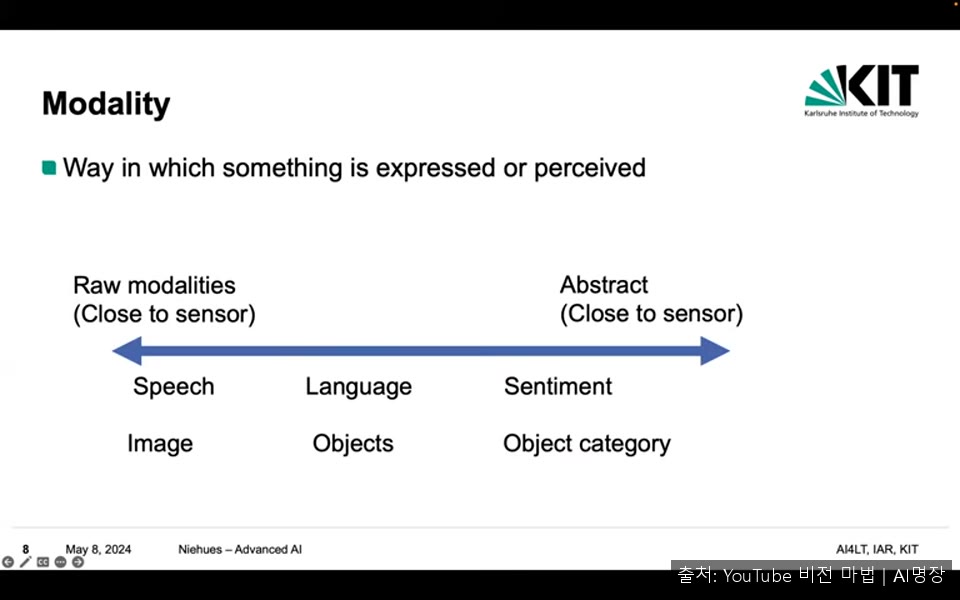
모달리티는 원시(raw) 형태와 추상화된 형태로 나눌 수 있다. 음성은 원래 신호, 전사된 텍스트, 감정 같은 요약 정보가 모두 입력이 될 수 있고, 이미지도 원본 픽셀에서 객체 분할 결과나 객체 범주까지 다양하게 쓸 수 있다. 복잡한 과제에서는 추상화된 입력이 도움이 되기도 하지만, 최근에는 딥러닝 덕분에 원시 데이터를 직접 다루는 연구가 늘고 있다.
⏱ 14:006. 이질성과 표현 방식의 차이
⏱ 14:00여러 모달리티를 합칠 때 가장 큰 어려움은 이질성(heterogeneity)이다. 텍스트는 간결하지만 음성은 길고 변동성이 크며, 같은 문장도 여러 방식으로 말할 수 있다. 데이터의 규모와 가용성, 잡음 수준도 모달리티마다 다르다.
구조 측면에서도 차이가 있다. 이미지는 정적이고 공간 정보를 담지만 영상은 시간 축이 추가된다. 따라서 정적 정보와 시간적 정보를 결합하려면 어느 시점이 어떤 요소에 대응하는지 맞추는 정렬 과정이 필요하다. 표현 공간에서도 단어처럼 이산적인 신호와 연속적인 신호가 공존하며, 해석 가능한 정보와 수치 중심 정보의 밀도 차이도 고려해야 한다.