요약
교재 9장의 PSRO와 집단 학습 개념을 복습한 뒤, 알파스타 프로젝트의 배경을 소개하는 강의다. 스타크래프트 II의 제로섬 경쟁 구조, 부분 관측 환경, APM 같은 평가 쟁점을 설명하고, 장기 계획을 위해 인간 데이터가 필요했던 이유를 짚는다.
⏱ 00:001. PSRO와 집단 학습의 기본 아이디어
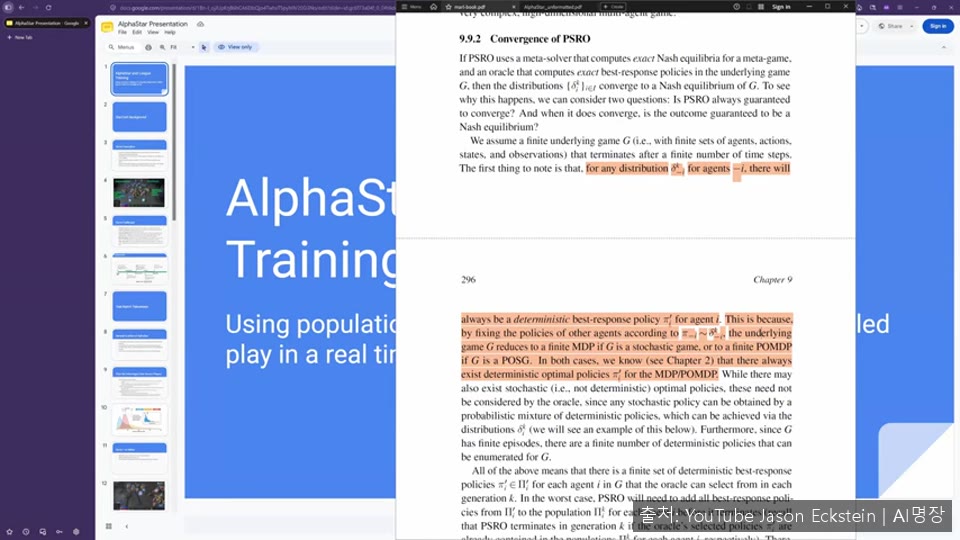
⏱ 00:00강연은 교재 9장 말미의 집단 학습(population training) 내용을 이어받아 시작한다. 앞선 회차에서 PSRO 알고리즘을 자세히 다뤘고, 가위바위보 같은 단순한 예로 정책이 단계적으로 추가되며 메타게임에서 쌍별 상호작용을 평가해 내쉬 균형을 구하는 과정을 복습한다.
⏱ 03:052. AlphaStar와 리그 학습 소개
⏱ 03:05교재 끝의 AlphaStar 주석은 PSRO와 다른 집단 학습 방식을 다룬다. 발표자는 AlphaStar 논문이 셀프 플레이(AlphaGo식)와 비교하면서 리그 학습(league training)을 제시했지만, PSRO와는 직접 비교하지 않았다고 짚는다.
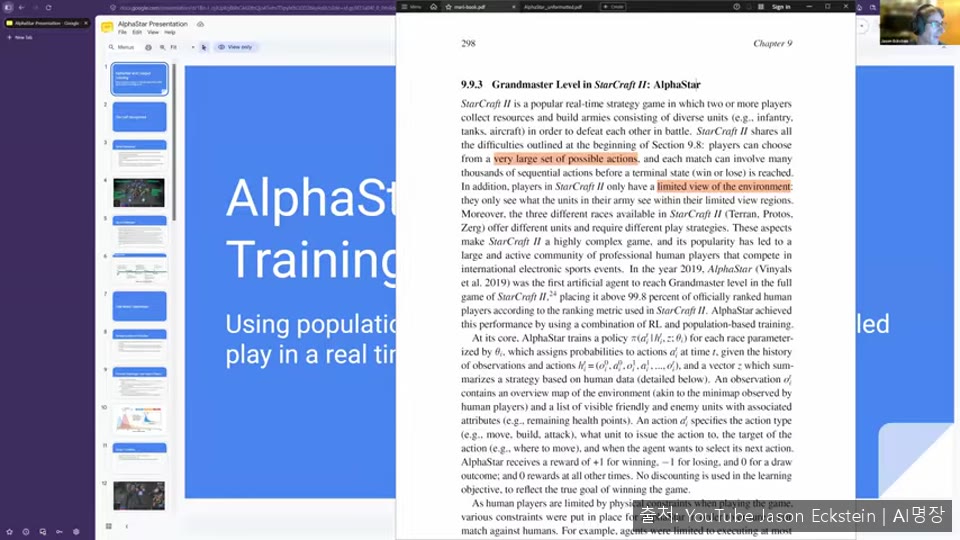
이번 회차는 교재의 수식보다 딥마인드가 블로그에서 밝힌 프로젝트 전개 과정과 초기 시연 결과에 초점을 맞춘다고 예고한다. 수학적 세부 내용은 이후 회차나 Nature 논문에서 더 다룰 수 있다고 덧붙인다.
⏱ 05:203. 스타크래프트의 경쟁 구조와 종족
⏱ 05:20스타크래프트는 경쟁형 게임의 대표 사례로 소개된다. 정기적인 프로 대회와 등급 체계가 있었던 게임으로 설명되며, 주로 1대1 경기로 진행된다. 승패만이 최종 점수를 결정하므로 승리하면 1, 패배하면 -1 보상을 주는 제로섬 게임으로 모델링할 수 있다. 무승부는 사실상 드물어 논외로 한다.
종족은 세 가지이며 각기 다른 플레이 스타일을 가진다. 한 종족이 일방적으로 우세하지 않아 가위바위보처럼 순환적 상성이 일부 존재하지만, 종족 내 특정 빌드나 유닛 조합이 유리한 경우도 있다. 따라서 상대에게 적응하지 않아도 특정 빌드가 이길 수 있어, 플레이어는 한 방향에 취약해지지 않도록 운영해야 한다. 알파스타는 세 종족을 모두 플레이할 수 있는 에이전트를 만들었지만 스타일이 달라 종족별로 구분된 에이전트로 본다. 발표에서는 프로토스 종족을 중심으로 본다.
⏱ 10:004. 게임 진행과 부분 관측 인터페이스
⏱ 10:00게임 진행 방식도 설명된다. 자원을 수집하고 건물을 짓고 병력을 모은 뒤 실시간으로 교전해 상대 기지를 파괴하는 것이 목표다. 초반에는 일꾼 유닛(프로브)으로 자원을 모으고, 일꾼과 병력 중 자원을 어디에 투입할지가 공격 시점을 좌우하는 전략 결정이 된다.
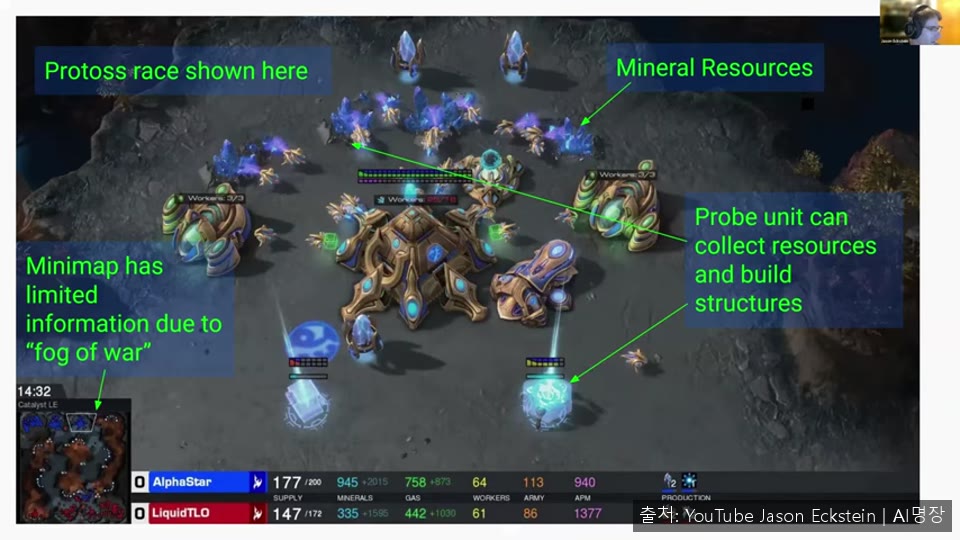
관측 측면에서는 직접 본 영역만 보이는 부분 관측(partially observable) 환경이다. 미니맵은 탐험한 곳만 밝혀지고, 과거에 본 정보는 기억으로 남지만 유닛 위치는 바뀐다. 화면 하단의 APM(분당 행동 수)은 실시간 조작 능력의 지표로, 봇이 인간을 넘는 행동 빈도를 내는지가 중요한 평가 쟁점이라고 강조한다.
⏱ 12:285. 장기 계획, 인간 데이터, 연산 제약
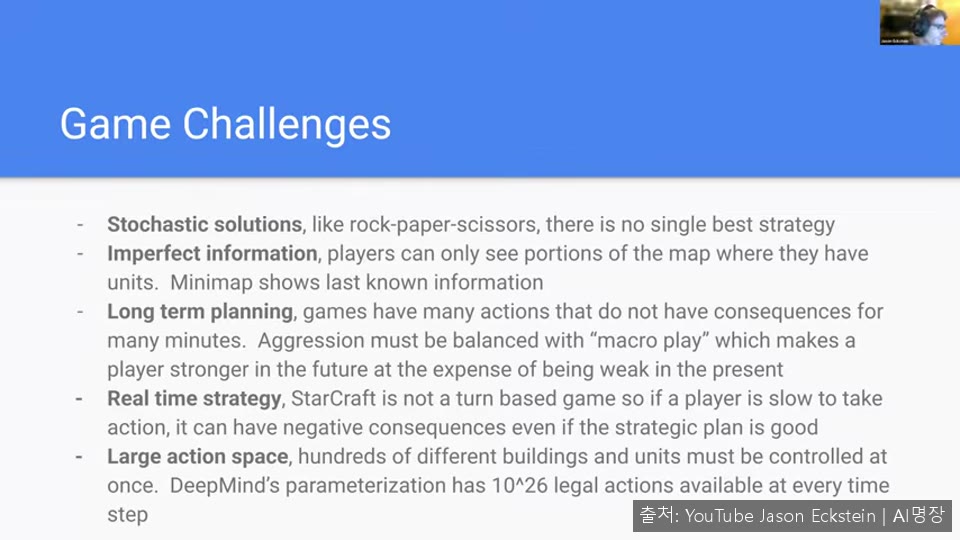
⏱ 12:28딥마인드가 이 게임에 주목한 이유는 확률적 해가 필요한 상황, 불완전 정보, 장기 계획이 함께 나타나기 때문이다. 수천 번의 행동 뒤에야 결과가 드러나므로 오래 전 행동의 공헌도를 따지기 어렵다. 발표자는 인간 데이터 없이는 에이전트가 장기 계획을 스스로 익히기 어려웠고, 초기 인간 데이터로 시드를 준 훈련이 필요했다고 설명한다. 특히 게임 초반 몇 분의 자원 수집처럼 정형화된 부분에서 인간 데이터가 도움이 되었다고 한다.