요약
⏱ 00:001. 학습과 미적분의 연결
⏱ 00:00에이전트의 모든 선택은 신경망 내부의 수많은 매개변수에서 나오며, 학습은 이 숫자들을 더 나은 행동 쪽으로 미세 조정하는 과정입니다. 강연자는 이 조정 방법을 묻는 가장 명확한 언어가 미적분이라고 말합니다.
⏱ 01:022. 도구 선택 한 번을 따라가기
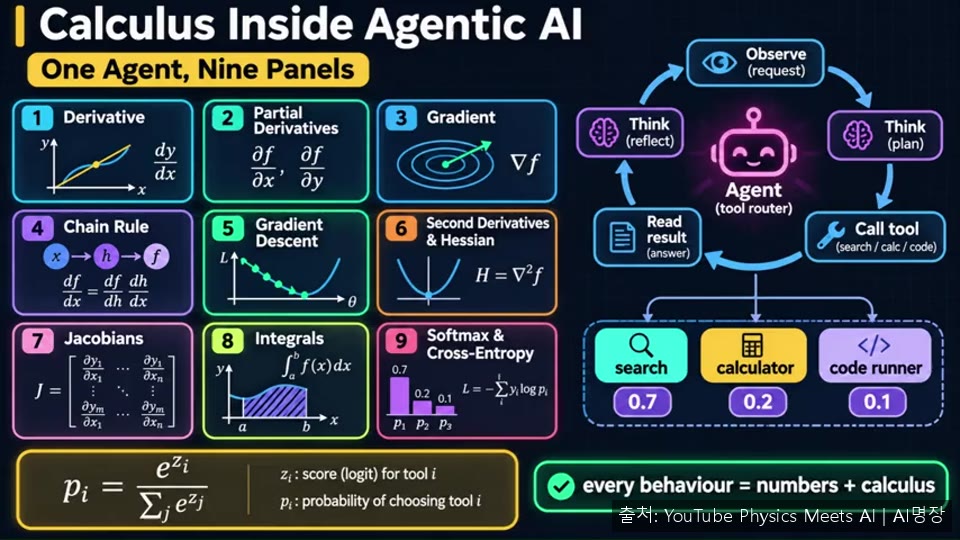
⏱ 01:02사용자가 2,340의 18%를 계산해 달라고 요청하자, 네트워크는 검색, 계산기, 코드 실행기에 대한 원시 점수인 로짓을 만들고 소프트맥스가 이를 확률로 바꿉니다. 이 예시에서는 검색 도구가 0.7로 선택되었지만 최적 도구는 계산기였고, 교차 엔트로피 손실은 약 1.609로 측정됩니다.
⏱ 02:053. 정책, 기대 보상, 미분의 정의
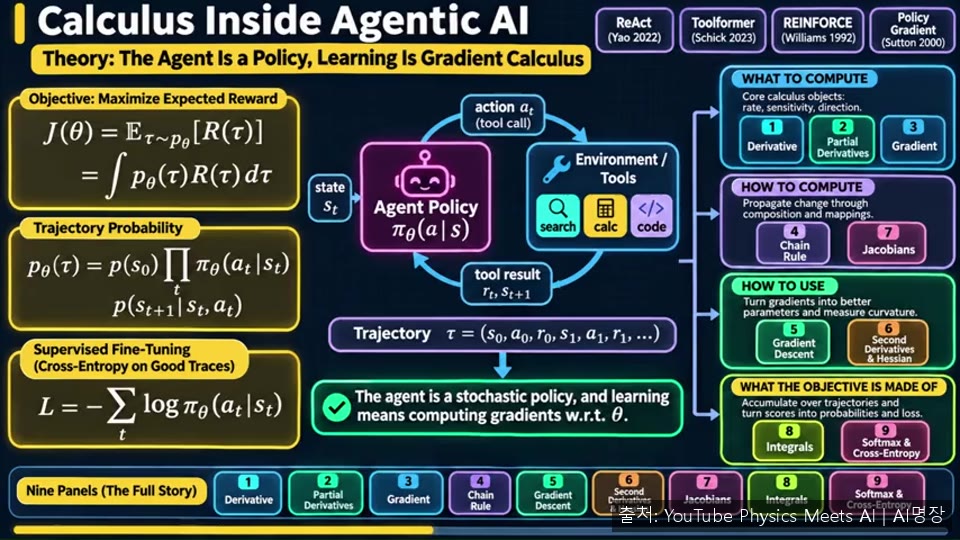
⏱ 02:05에이전트는 상태가 주어졌을 때 각 행동에 확률을 부여하는 확률적 정책으로 볼 수 있으며, 한 에피소드의 궤적 확률은 정책 항과 환경 항의 곱입니다. 목표는 기대 보상을 최대화하는 것이고, 지도 미세 조정은 좋은 궤적에서 교차 엔트로피를 줄이며, 강화학습은 정책 경사법을 따릅니다. 두 방식 모두 모든 매개변수에 대한 기울기 하나가 필요합니다.
⏱ 04:054. 거듭제곱, 곱, 활성화 함수의 미분
⏱ 04:05이항 정리로 X+H의 N제곱을 전개하면 N·X^(N-1)만 남아 거듭제곱 법칙이 나옵니다. 손실 (W-3)²의 기울기는 2(W-3)이 되어 W=3에서 0이 되며, 강연은 W가 0, 1, 3, 5일 때 기울기가 각각 -6, -4, 0, 4임을 코드로 확인합니다. 곱의 법칙은 두 함수의 변화량을 묶어 유도하며, 게이트나 도구 신뢰도가 결과를 곱하는 구조에서 필요합니다.
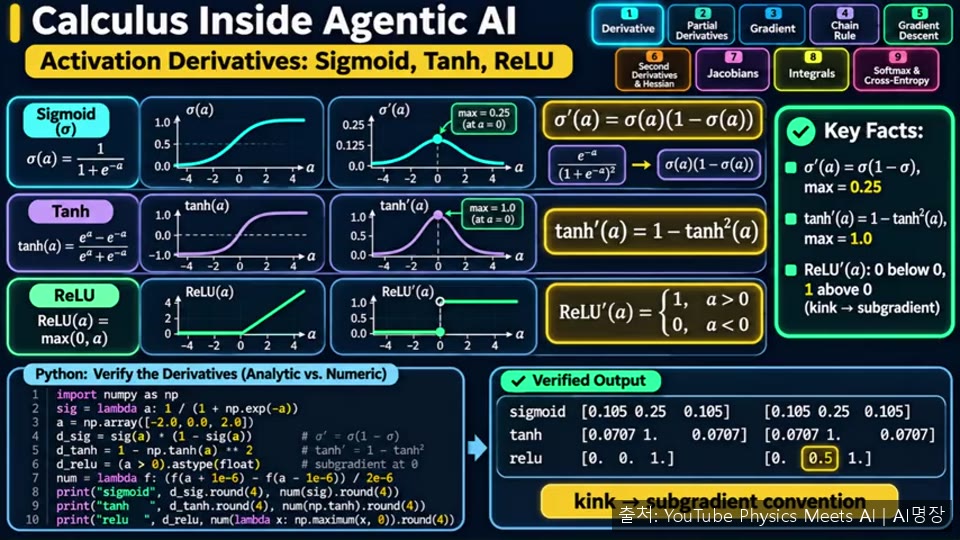
시그모이드의 도함수는 시그모이드 곱하기 (1-시그모이드)이며 최댓값이 1/4를 넘지 않습니다. tanh의 도함수는 1-tanh²이고, ReLU는 0 아래에서 기울기 0, 위에서 1입니다. 이 공식들은 중심 차분으로 검증되며 시그모이드 출력 예시로 0.105, 0.25, 0.105가 제시됩니다.
⏱ 07:005. 로그, 수치 미분의 오차, 자동 미분
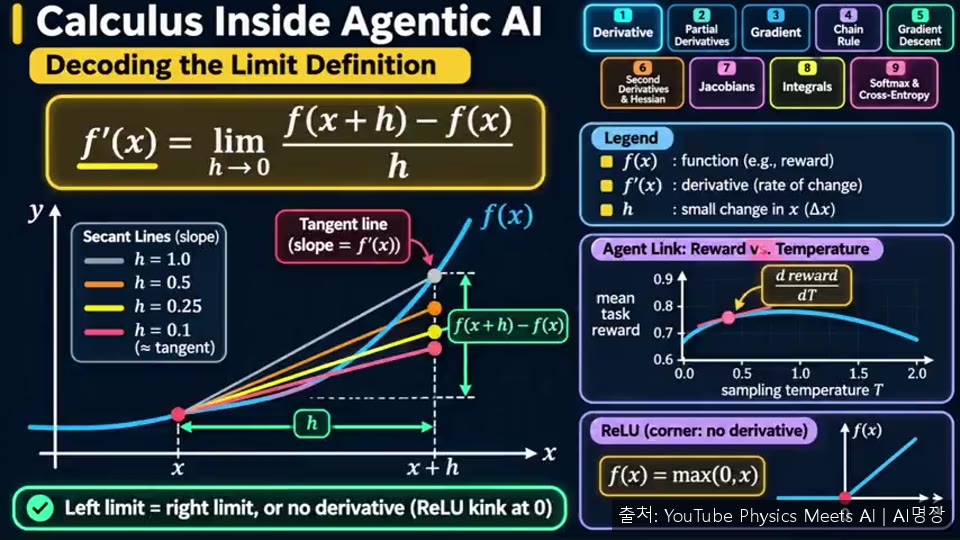
⏱ 07:00지수 함수는 도함수가 자기 자신과 같다는 성질을 극한으로 정의하며, 로그 함수는 역함수 관계를 이용해 1/x를 얻습니다. 정책 경사에서는 log P의 미분이 P의 미분을 P로 나눈 값이라는 점이 핵심이고, 로그 확률은 곱을 합으로 바꿔 언더플로를 막습니다.
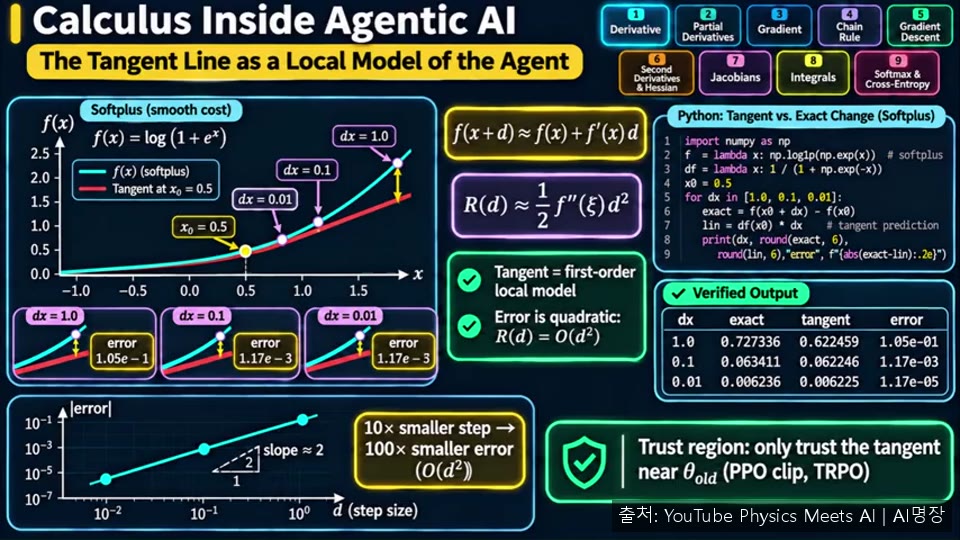
컴퓨터는 h를 0으로 만들 수 없어 수치 미분을 쓰지만, 전방 차분은 h에 비례하는 절삭 오차를, 중앙 차분은 h²에 비례하는 오차를 가집니다. 반올림 오차는 h로 나누는 과정에서 증폭되므로 최적의 h가 존재하며, 예시에서 전방 차분은 약 10⁻⁸, 중앙 차분은 약 10⁻⁶ 근처에서 최소 오차를 보입니다.
자동 미분은 엡실론의 제곱이 0인 쌍대수 a+bε를 도입해 f(a+bε)=f(a)+f'(a)bε로 값과 도함수를 함께 계산합니다. 두 쌍대수의 곱은 ad+bc를 내므로 곱의 법칙이 자동 적용되며, x=1에서 x·e^x+3x 형태의 식에 대해 값 5.71828과 도함수 8.43656(2e+3)이 일치합니다.
⏱ 11:006. 편미분, 헤시안, 선형 점수와 어텐션
⏱ 11:00입력이 여럿일 때 편미분은 나머지 입력을 고정하고 하나만 바꿀 때의 변화율이며, 전체 변화량은 각 편미분에 변화량을 곱한 값의 합으로 근사됩니다. 편미분의 순서를 바꿔도 결과가 같은 것은 슈바르츠 정리에 의해 보장되고, 매끄러운 손실의 헤시안은 대칭 행렬이 되어 곡률 분석과 신뢰 영역 방법의 바탕이 됩니다. 수치 편미분과 해석 편미분을 비교하는 단위 테스트는 학습 코드의 부호 오류를 잡는 데 쓰입니다.
선형 점수 s_k = Σ w_kj·x_j + b_k에서 가중치의 기울기는 해당 특징값이고, 특징값이 0이면 그 가중치의 기울기도 0입니다. 어텐션 점수 Q·K_j/√D에서 쿼리에 대한 기울기는 키를 √D로 나눈 값이며, 임베딩 테이블에서는 조회되지 않은 행의 기울기가 0이라 희소 업데이트가 생깁니다. 영상은 온도, 검색 문서 수, 최대 단계 수에 대한 민감도를 탄력성으로 비교하는 대목에서 자막이 끊깁니다.