요약
발표자는 에이전트의 모든 선택이 신경망 매개변수에서 나오며, 그 조정에 미적분이 필요하다고 설명합니다. 라우터 예제에서 교차 엔트로피 손실의 기울기를 구해 경사 하강법으로 도구 선택 확률을 바꾸는 과정을 따라가고, 도함수·편미분·활성화 함수 미분·자동 미분을 파이썬 코드로 검증합니다. 선형 층, 어텐션, 임베딩의 기울기 흐름까지 다룹니다.
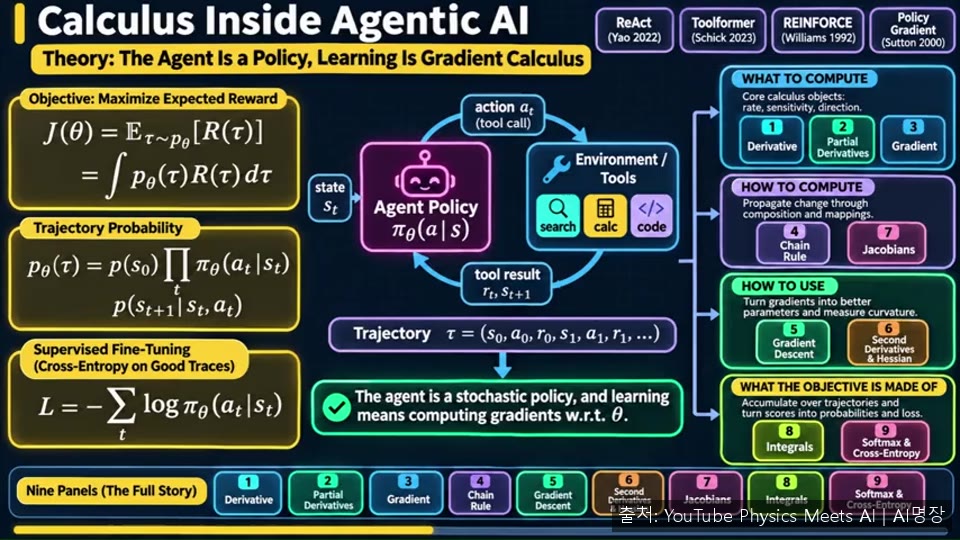
⏱ 00:001. 도입과 라우터 에이전트 예제
⏱ 00:00에이전트가 도구를 고르고 답을 다시 생각하는 모든 선택은 신경망의 수많은 매개변수에서 나오며, 학습은 이 값들을 조정하는 일입니다. 발표자는 이 조정 방법을 설명하는 데 미적분이 가장 믿을 만한 언어라고 말하고, 그 도구들을 아홉 개의 공식 패널로 정리합니다.
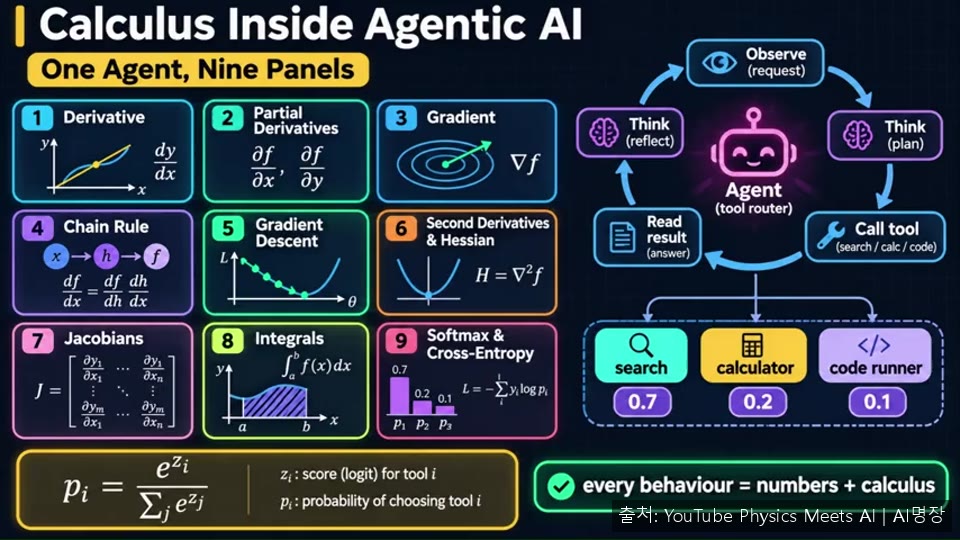
예제는 검색, 계산기, 코드 실행기 중 하나를 0.7, 0.2, 0.1의 확률로 고르는 라우터 에이전트입니다. 사용자가 2,340의 18%를 계산해 달라고 했을 때 에이전트는 최적 도구인 계산기 대신 검색을 골랐고, 교차 엔트로피가 이 실수를 약 1.609로 측정합니다. 이 손실에서 출발해 기울기를 계산하고 경사 하강법으로 다음번 계산기 선택 확률을 높이는 과정이 한 단계에서 펼쳐집니다.
⏱ 03:072. 도함수의 정의와 기본 법칙
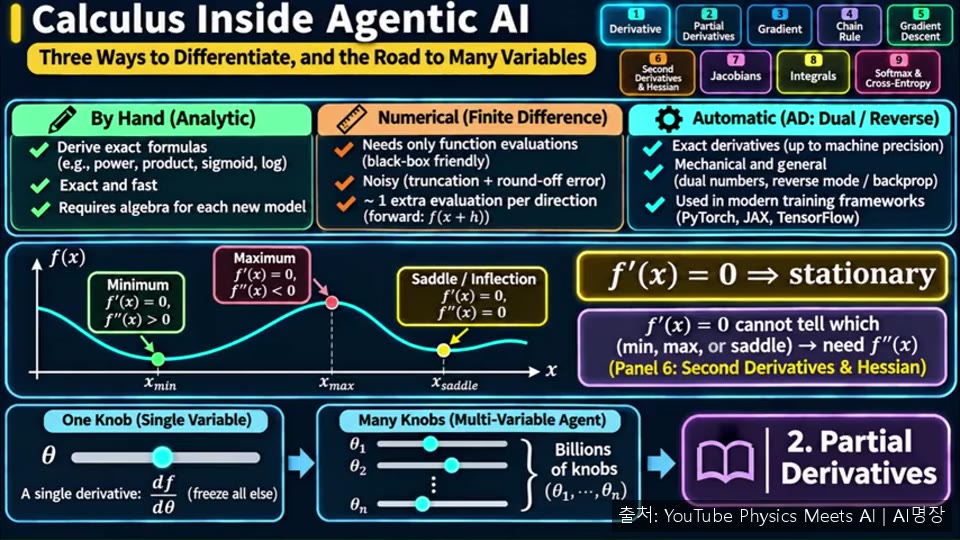
⏱ 03:07도함수는 h가 0에 가까워질 때 (f(x+h)-f(x))/h의 극한으로 정의되며, 곡선 위 두 점을 잇는 할선이 접선으로 수렴하는 과정입니다. 에이전트에서는 샘플링 온도 같은 노브를 돌릴 때 단위당 보상이 얼마나 변하는지를 묻는 질문에 해당합니다. 극한은 좌우 접근이 일치해야 존재하므로 ReLU의 꺾이는 점처럼 뾰족한 곳에는 관례적 정의가 필요합니다.
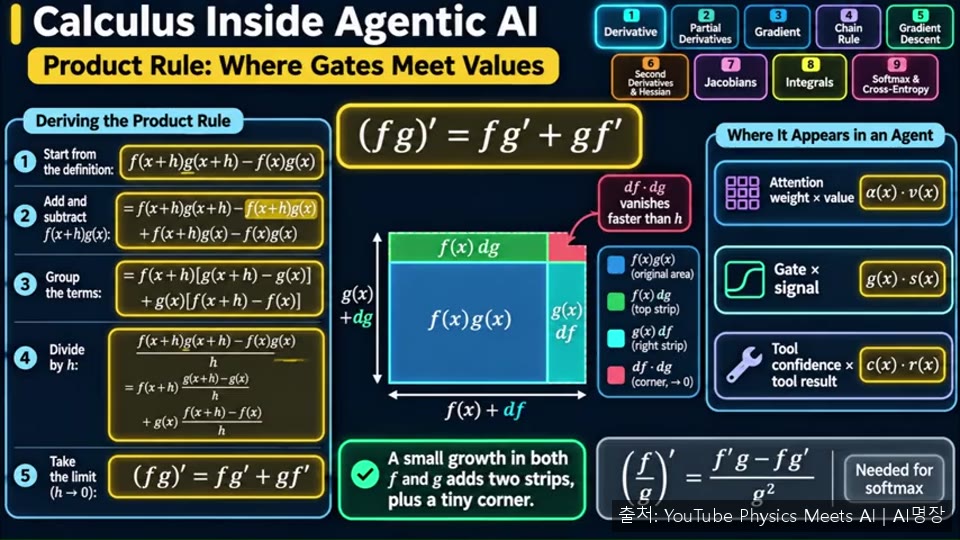
이항정리로 (x+h)^n을 전개하면 x^n의 미분이 n·x^(n-1)임을 얻고, 손실 L(w)=(w-3)^2에 적용하면 기울기는 2(w-3)이 됩니다. 곱셈 법칙은 중간 항을 더하고 빼는 기법으로 (fg)' = f'g + fg'를 유도하며, 기하학적으로는 직사각형 넓이의 변화로 해석됩니다. 코드는 w가 0, 1, 3, 5일 때 기울기 -6, -4, 0, 4를 확인하고, w=3이 손실의 바닥임을 보여 줍니다.
⏱ 06:003. 활성화 함수의 미분과 로그·지수
⏱ 06:00시그모이드 σ(a)=1/(1+e^(-a))의 미분은 σ(1-σ)로 쓸 수 있으며, 최댓값이 1/4를 넘지 않습니다. 탄젠트의 미분은 1-tanh²로 최대 1이고, ReLU는 0 미만에서 기울기 0, 초과에서 1이며 0에서는 관례값을 씁니다. 코드는 이 공식들을 중앙 차분과 비교해 검증하고, 수치 ReLU가 0에서 양쪽 기울기의 평균인 0.5를 반환하는 것을 보여 줍니다.
지수 함수는 극한 정의로 e를 얻으면 (e^x)'=e^x가 되고, 자연로그의 미분은 1/x입니다. 확률 P(θ)에 대해 (log P)' = P'/P라는 관계를 쓰면 P' = P·(log P)'로 바뀌고, 이는 정책 경사법에서 미분을 샘플 기댓값으로 바꾸는 핵심입니다. 로그는 곱을 합으로 바꿔 궤적 확률의 언더플로를 막아 줍니다.
⏱ 08:004. 수치 미분의 오차와 자동 미분
⏱ 08:00컴퓨터는 h를 0으로 보낼 수 없으므로 테일러 전개로 오차를 분석합니다. 전진 차분의 절단 오차는 f''·h/2 정도이고, 중앙 차분은 짝수 항이 상쇄되어 h² 수준의 오차가 남습니다. 그러나 부동 소수점의 반올림 오차가 h로 나누는 과정에서 증폭되어, 오차를 최소화하는 h는 방법에 따라 특정 범위에 머뭅니다. 이런 이유로 블랙박스 도구는 수치 미분으로만 조사할 수 있습니다.

자동 미분은 ε²=0을 만족하는 이중수 a+bε를 도입해 F(a+bε)=F(a)+F'(a)bε로 도함수를 정확히 얻습니다. 곱셈은 AD+BC로 곱의 법칙이 자동으로 나타나며, 코드의 dual 클래스는 값과 미분 필드를 함께 전파합니다. X·e^X+3X를 x=1에서 평가하면 값 약 5.718과 미분 약 8.437(2e+3)이 나오며, 이 방식이 학습 프레임워크가 쓰는 방식입니다.
⏱ 12:045. 편미분과 기울기
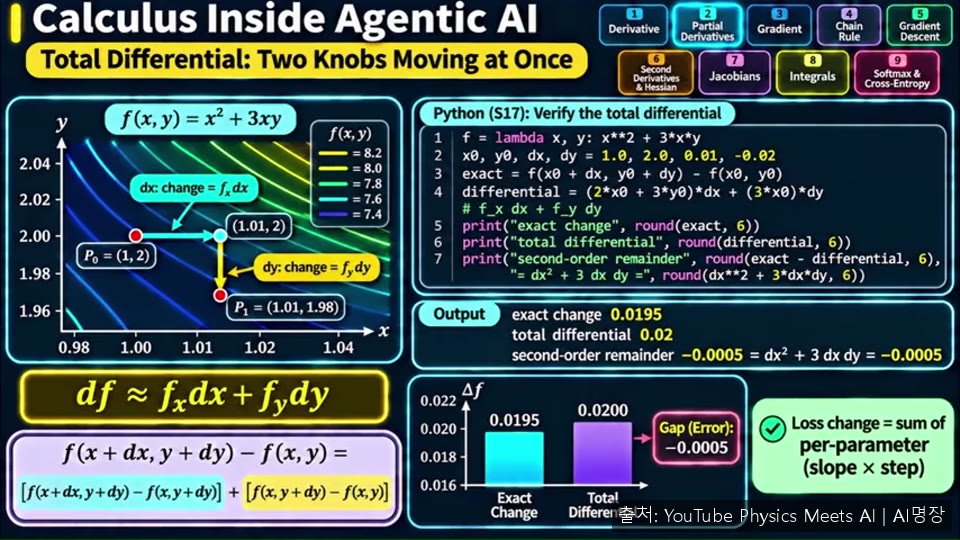
⏱ 12:04입력이 여럿인 함수에서 편미분은 다른 입력을 고정한 채 하나의 입력에 대해 미분하는 것입니다. 두 입력을 가진 함수는 곡면이고, 한 변수를 고정해 자른 단면 곡선의 기울기가 편미분에 해당합니다. 예시 F(x,y)=x²+3xy에서 ∂F/∂x=2x+3y, ∂F/∂y=3x이며, (1,2)에서 각각 8과 3입니다. 이 값들을 모으면 기울기 벡터가 됩니다.
코드는 중앙 차분으로 구한 수치 편미분이 해석적 값과 일치함을 확인하며, 이런 대조 습관이 부호 오류와 인덱스 혼동을 막는다고 강조합니다. 편미분의 순서를 바꿔도 같은 값이 나오는 것은 슈바르츠 정리 덕분이며, 이것이 헤세 행렬의 대칭성과 직교 고유벡터 성질의 근거입니다. 여러 입력이 동시에 변할 때 전체 변화량은 대략 F_x·Δx + F_y·Δy로 근사됩니다.
⏱ 17:006. 선형 층, 어텐션, 임베딩의 기울기
⏱ 17:00도구 점수 s_k = Σ w_kj·x_j + b_k에서 가중치에 대한 편미분은 해당 피처 값 x_j이고, 편향에 대한 편미분은 1입니다. 다른 도구의 가중치에 대한 편미분은 0이므로 기울기는 선택적으로 흐르며, 쿼리에 없는 피처의 가중치 기울기는 0이 됩니다. 예측 오차 제곱의 1/2을 손실로 쓰면 편미분은 (ŷ-y)·x_j로 정리되고, 예시에서 기울기는 -1.3, -2.6, +1.3으로 수치 확인과 일치합니다.
스케일드 닷 프로덕트 어텐션에서 점수는 Q·K_j를 √D로 나눈 값이며, 쿼리 기울기는 키 벡터를 √D로 나눈 값입니다. 임베딩 테이블에서는 조회되지 않은 행의 기울기가 0이고 사용된 행만 상류 기울기를 받으므로 업데이트가 희소합니다. 이 때문에 드문 도구 토큰은 등장할 때만 기울기를 받아 초기 학습이 느릴 수 있습니다.
⏱ 20:507. 민감도 분석과 기울기 벡터
⏱ 20:50성공률이 온도, 검색 문서 수, 최대 단계 같은 설정에 달려 있을 때, 중심 차분으로 구한 각 편미분은 단위가 달라 직접 비교하기 어렵습니다. 이를 해결하기 위해 기울기에 x/s를 곱한 탄력성을 쓰면, 온도 -0.28, 문서 +0.079, 단계 +0.105가 나옵니다. 이 예시 모형에서는 온도가 가장 큰 부정적 영향을 주고, 단계 수가 문서 수보다 약간 더 도움이 됩니다. 발표자는 이 값들이 측정 데이터가 아닌 예시 공식에서 나왔음을 명시합니다.
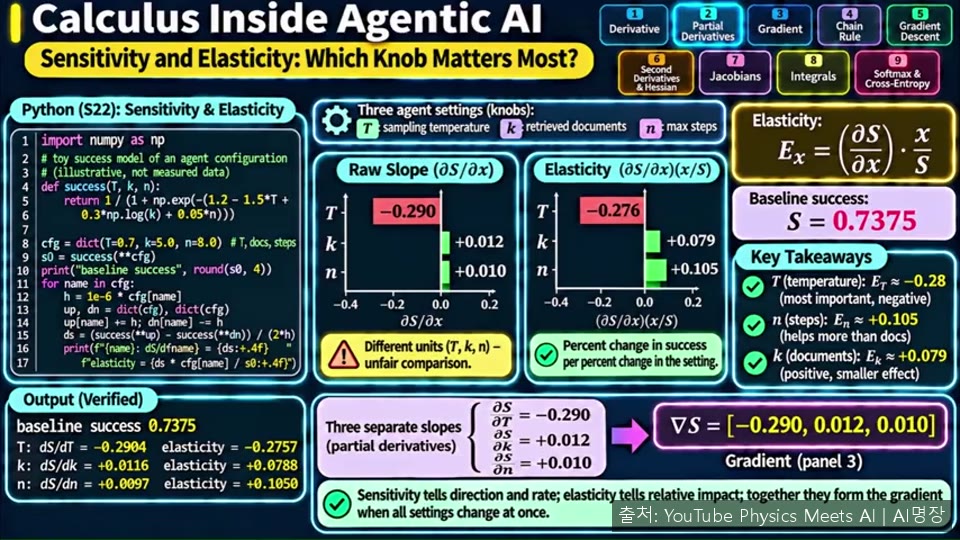
여러 매개변수의 편미분을 한데 모은 열 벡터가 기울기이며, 이는 여러 설정을 동시에 바꾸는 방법으로 이어집니다. 편미분은 이렇게 민감도 보고서 역할도 합니다.