요약
Liquid AI의 LFM3 Omni는 약 22억 파라미터 규모로 음성 인식, 이미지 이해, 언어 생성, 음성 합성을 하나로 묶은 모델이다. 발표자는 화면과 소리를 함께 처리하는 방식, 실사용 때 주의할 설정, 강점과 약점, 앱별 기능 차이와 메모리 요구, 라이선스 조건까지 차례로 짚는다. 점수가 모두 제작사 자체 실험 결과라는 점도 함께 강조한다.
⏱ 00:001. 모델 개요와 핵심 주장
⏱ 00:00Liquid AI가 공개한 LFM3 Omni는 약 22억 파라미터 규모의 작은 모델 하나로 음성 인식, 이미지 이해, 언어 생성, 음성 합성 네 가지 기능을 묶은 오픈 웨이트 모델이다. 발표자는 이 모델이 사진과 영상을 보고, 소리를 듣고, 소리 내어 답할 수 있는지를 확인하면서 어디서 강하고 어디서 약한지, 그리고 실제로 어떤 환경에서 돌려볼 수 있는지를 살펴본다.
다만 발표 시점의 점수는 모두 Liquid 자체 실험에서 나온 것이며 독립적인 검증은 아직 없었다는 점을 먼저 짚고 들어간다.
⏱ 00:502. 화면과 소리를 처리하는 입력 구조
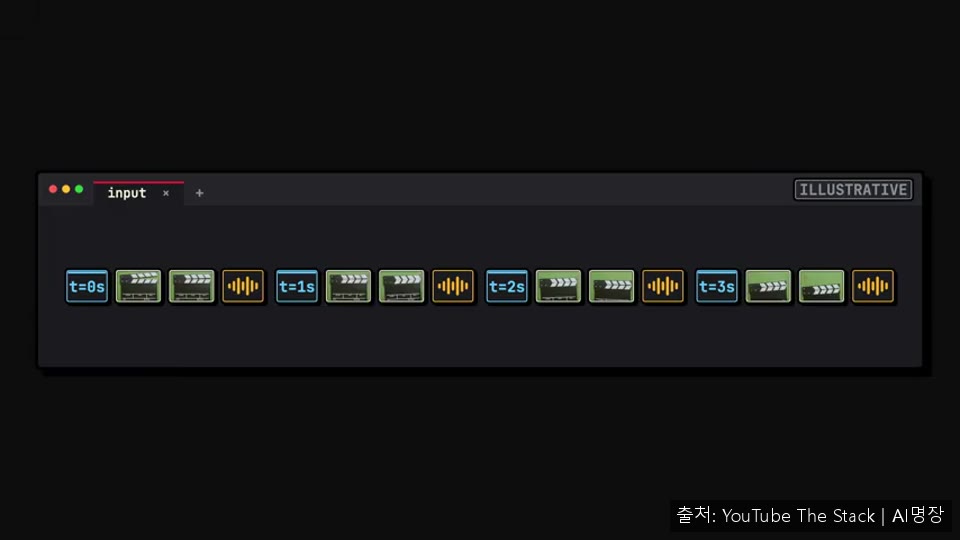
⏱ 00:50이 모델은 입력이 들어오는 순서대로 정보를 처리한다. 정지 이미지는 원래 해상도 그대로 처리하며, 2×2 패치 묶음 하나를 언어 토큰 하나로 바꾼다. 영상은 초당 두 프레임으로 들어오는데, 두 프레임마다 시간 표시가 붙고 그 뒤에 같은 순간의 소리가 이어진다. 이렇게 같은 순간의 화면과 소리가 함께 들어오기 때문에 화면에서 일어나는 일과 들리는 말을 엮어서 질문에 답할 수 있다.
음성 인코더는 말하는 도중에 이미 처리를 시작해 발화가 끝난 뒤의 대기 시간을 줄인다. 응답은 텍스트와 음성이 섞여 나오므로 전체 답변이 완성되기 전에 목소리가 먼저 시작될 수 있다. 음성 코덱은 80밀리초 분량의 음성을 토큰 12개로 바꾸며, Liquid는 M4 Max의 CPU 스레드 하나에서 실시간보다 약 87배 빠르게 디코딩된다고 보고한다.
⏱ 01:563. 실제 사용 시 주의할 설정
⏱ 01:56공식 파이썬 예제에서는 플래그 두 개를 켜지 않으면 영상이 소리 없이 프레임만 들어간다. 그대로 쓰면 모델은 소리를 듣지 못하므로 설정을 꼭 확인해야 한다.

컨텍스트 창은 3만 2천 토큰이며 질문, 미디어, 답변이 모두 이 안에 들어가야 한다. 영상의 각 프레임은 토큰을 더 쓰기 때문에 긴 영상은 프레임 속도를 낮추거나 프레임 수를 제한해야 한다. 이 설정은 화면 프레임에만 영향을 주고 소리는 항상 전부 들어간다. 긴 영상에서 줄어드는 것은 프레임이지 소리가 아니다.
⏱ 02:254. 강점과 약점의 실제 수치
⏱ 02:25작은 모델이 큰 모델을 앞서는 영역은 분명하다. Liquid의 표에서 Qwen 계열 비교 모델은 전체 파라미터가 약 60억, Gemma 4 E2B는 약 50억으로 소개되는데, 영상과 소리를 함께 쓰는 세 가지 시험에서는 이 모델이 더 높은 점수를 받았다. 다만 이 우위는 영상과 소리가 함께 있을 때에 한정된다. 정지 이미지와 오디오를 함께 쓰는 OmniBench에서는 Qwen의 옴니 모델 두 개보다 약간 낮았다.
질문을 말로 하면 정확도가 떨어진다. 이미지 질문 시험인 MMStar에서 텍스트로 물었을 때 약 56점이던 점수가 같은 질문을 음성으로 했을 때 약 52점으로 내려갔다. 도구 호출에서는 차이가 더 크다. Liquid의 자체 평가에서 음성 요청에 따른 도구 호출은 약 52점이었고 Gemma 4 E4B는 약 72점이었다. 음성 명령으로 앱 기능을 실행하려는 용도라면 이 차이가 중요하다. 또 이 모델은 추론 단계가 없고 생각 모드도 지원하지 않는다.
⏱ 04:465. 앱별 기능 차이와 필요한 하드웨어
⏱ 04:46같은 가중치라도 어떤 앱에서 여느냐에 따라 쓸 수 있는 기능이 달라진다. Liquid의 모델 카드는 macOS와 Windows의 Llama.app이 이미지, 음성, 영상 입력을 모두 받는다고 하지만, Llama.app의 모델 페이지에는 영상 입력이 빠져 있다. Ollama를 macOS에서 쓰면 이미지와 음성만 가능하고, LM Studio에서는 이미지 입력만 가능하다. 음성으로 주고받는 실시간 대화를 원하면 llama.cpp 서버의 Omni 빌드를 실행해야 한다. 이 경로에서는 영상 샘플링이 초당 두 프레임으로 고정되고 초당 프레임 수 플래그는 효과가 없다. GPU용 SGLang 경로는 텍스트 응답만 지원한다.
메모리도 1기가바이트라는 헤드라인보다 넉넉히 잡아야 한다. 약 1GB라는 수치는 텍스트 모델 기준이고, Ollama의 Omni 파일은 컨텍스트를 제외하고도 2.4GB다. 인코더, 컨텍스트 상태, 런타임 오버헤드가 모두 메모리를 쓴다. Llama.app은 8비트 빌드에 8GB 이상의 메모리를 권장하고, Python Transformers 가이드는 GPU를 권장한다. 노트북과 휴대폰용으로는 압축된 llama.cpp 빌드가 있다.
⏱ 06:336. 라이선스 조건과 최종 판단
⏱ 06:33직접 실행해보는 것은 무료지만 제품으로 배포할 때는 라이선스 조건을 따져야 한다. 기반은 Apache 라이선스이지만 상업적 무상 사용은 연매출 1천만 달러까지로 제한된다. 이 한도는 모기업과 동일 지배 아래의 계열사까지 합산해 계산한다. 공식 FAQ에 따르면 내부 연구, 테스트, 평가는 상업 라이선스 없이 허용되지만, 일상 업무 운영에 모델을 쓰는 것은 직접 매출을 내지 않더라도 상업적 사용으로 볼 수 있다. 출시 글에는 라이선스 내용이 언급되지 않는다.
결론적으로 개인이 쓰는 로컬 비서처럼 화면과 소리를 함께 보고 듣고 말로 답하는 용도라면 시도해볼 만하다. 도구 호출이나 단계별 추론이 필요하다면 더 큰 모델을 함께 두는 것이 낫다. 제작사 수치를 믿기 전에 자신의 녹음을 llama.cpp 서버에서 직접 돌려 확인하는 것이 좋다.