요약
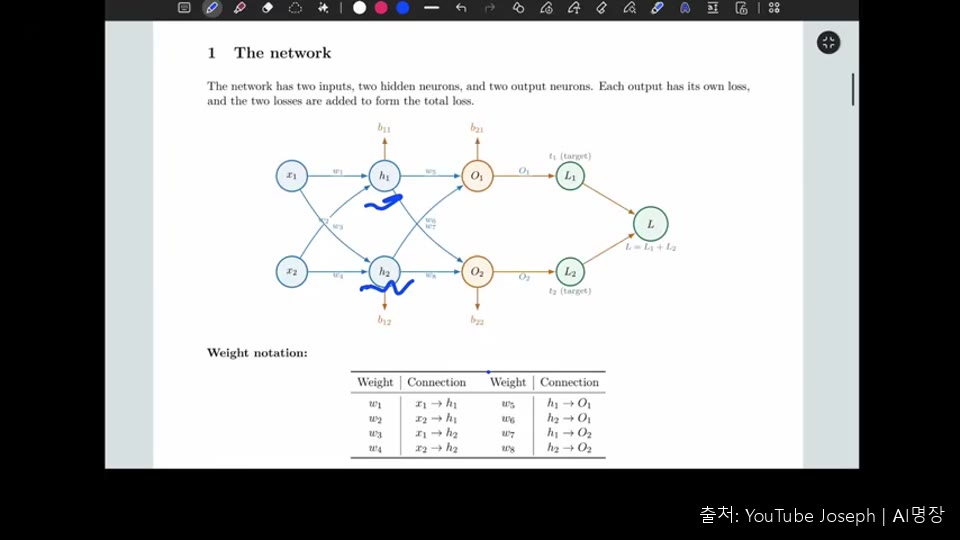
⏱ 00:011. 네트워크 구조 소개
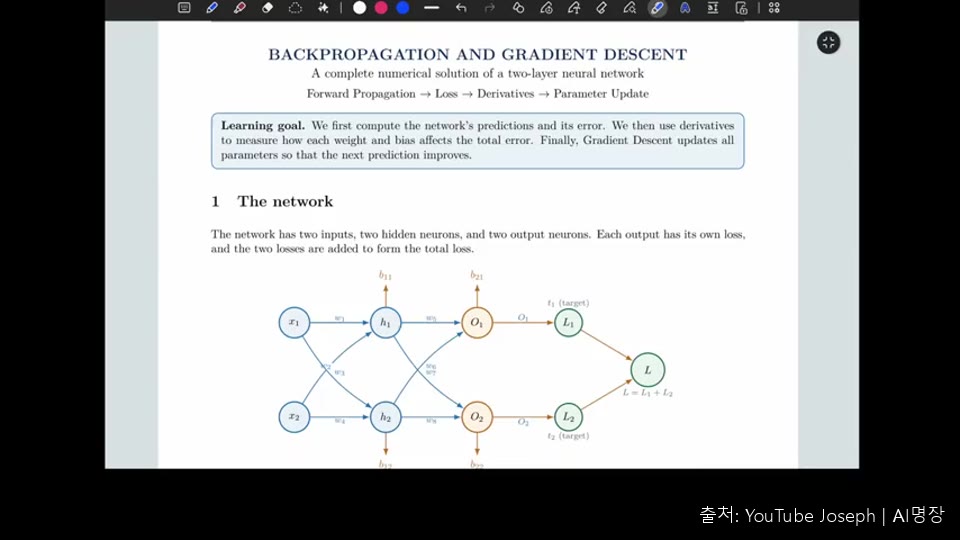
⏱ 00:01강의는 역전파의 수학적 원리를 이해하기 위한 보충 강의로, 아주 단순한 신경망을 예로 듭니다. 입력 X1, X2, 은닉 뉴런 H1, H2, 출력 뉴런 두 개로 이루어지며, 각 출력은 자체 손실(loss)을 가지고 이를 더해 최종 손실을 만듭니다.
⏱ 01:422. 입력값과 초기 설정
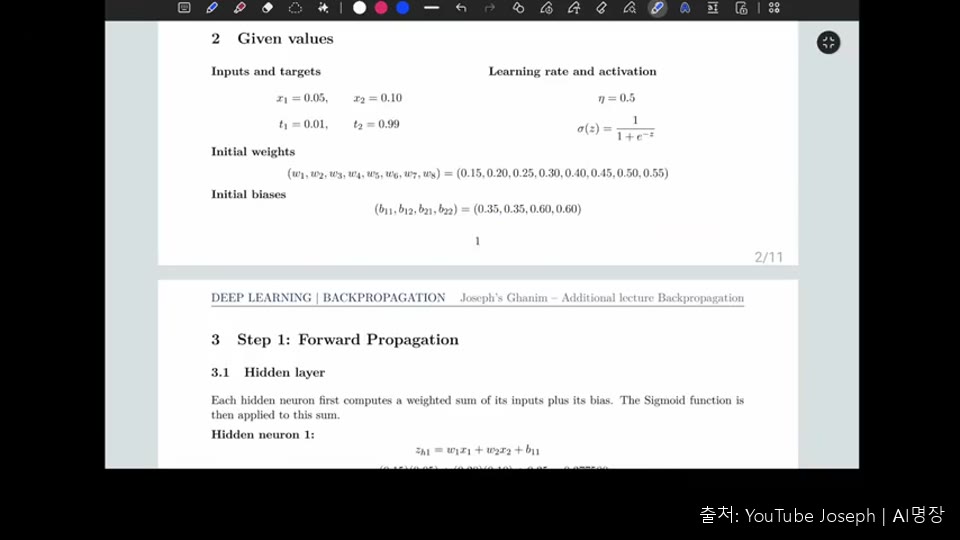
⏱ 01:42입력은 X1 0.05, X2 0.10이고 목표값은 첫 출력 0.01, 둘째 출력 0.99입니다. 학습률(eta)은 0.5로 설정됩니다. 초기 가중치와 편향은 임의로 고른 값으로, 네트워크가 아무것도 모르는 상태에서 출발한다는 점을 강조합니다.
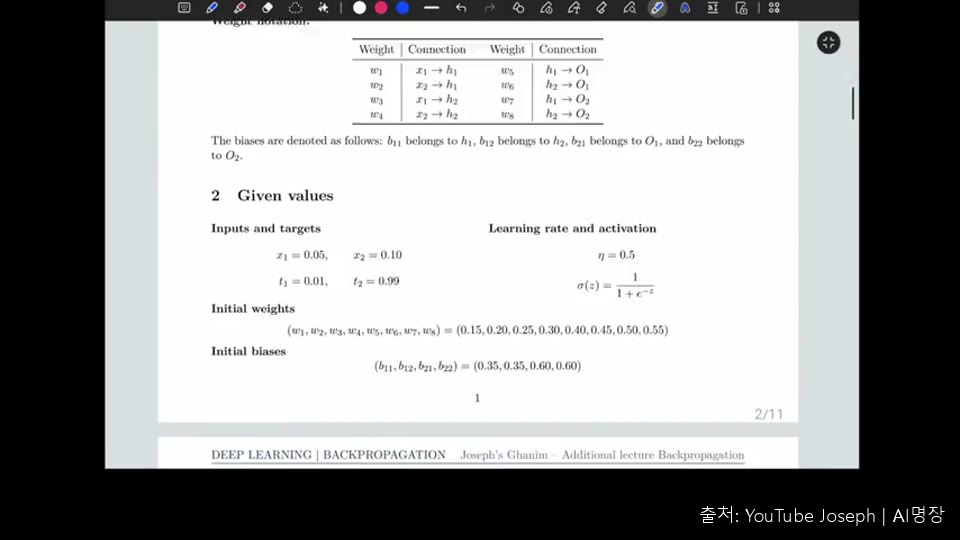
활성화 함수로는 시그모이드를 사용합니다. 시그모이드는 어떤 수를 0과 1 사이로 눌러 주는 함수로, 0을 넣으면 0.5가 나오고 큰 양수는 1에 가까워지며 큰 음수는 0에 가까워집니다. 미분이 편리하지만 기울기가 사라지는 문제(vanishing gradient)가 있다는 점도 언급됩니다.
⏱ 02:363. 순전파 과정
⏱ 02:36순전파는 현재 가중치와 편향으로 예측을 만드는 과정입니다. 각 뉴런은 입력의 가중합을 계산한 뒤 시그모이드를 통과시킵니다. 은닉층은 X1, X2를 받아 H1, H2를 만들고, 출력층은 X가 아니라 은닉층의 출력 H1, H2를 입력으로 받아 최종 출력을 만듭니다.
강사는 은닉층을 일종의 번역기에 비유합니다. 계산된 출력은 목표값과 큰 차이가 있었고, 첫 번째 출력은 특히 크게 빗나갔는데도 네트워크가 확신하고 있다는 점이 문제로 지적됩니다.
⏱ 06:514. 손실 함수와 손실 계산
⏱ 06:51출력 하나하나의 오차를 하나의 숫자로 바꾸기 위해 평균제곱오차(mean squared error)를 씁니다. 예측값과 목표값의 차이를 제곱하고 1/2을 곱하는 방식입니다. 제곱을 하는 이유는 오차의 부호가 상쇄되지 않게 하고, 큰 실수를 더 강하게 벌주며, 미분이 매끄럽기 때문이라고 설명합니다. 1/2은 미분할 때 지수를 소거하기 위한 편의상 항목입니다.
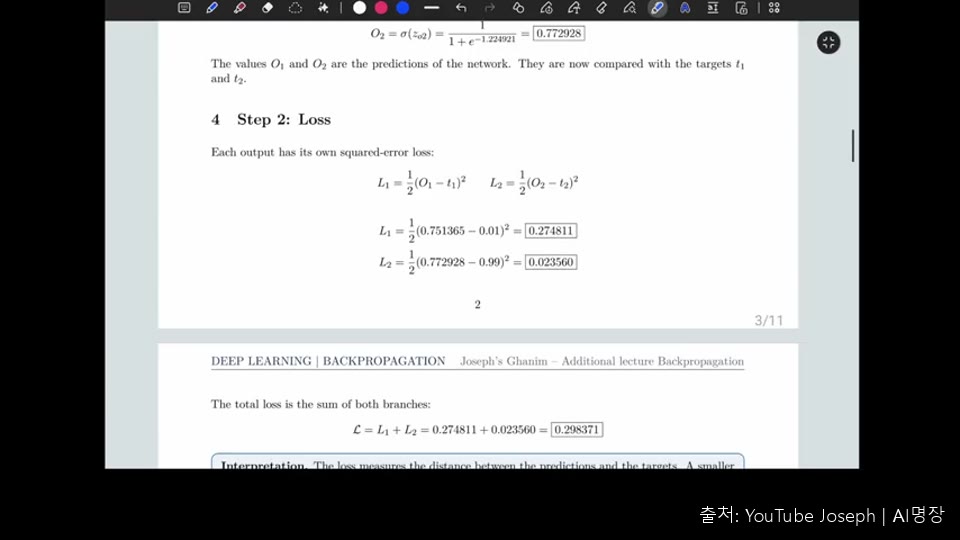
계산 결과 최종 손실은 약 0.298이며, 그 대부분이 첫 번째 출력에서 나온다고 강조합니다. 이 손실 값은 얼마나 틀렸는지만 알려 줄 뿐, 어떤 파라미터를 어느 방향으로 고쳐야 하는지는 알려 주지 않습니다.
⏱ 09:265. 기울기의 의미와 편미분
⏱ 09:26기울기(gradient)는 파라미터 하나를 아주 조금 바꿨을 때 손실이 얼마나, 어느 방향으로 변하는지를 알려 줍니다. 다른 값은 고정하고 하나만 움직이는 편미분으로 계산하며, 안개 낀 언덕에서 경사를 발끝으로 느껴 내려가는 방식에 비유됩니다.
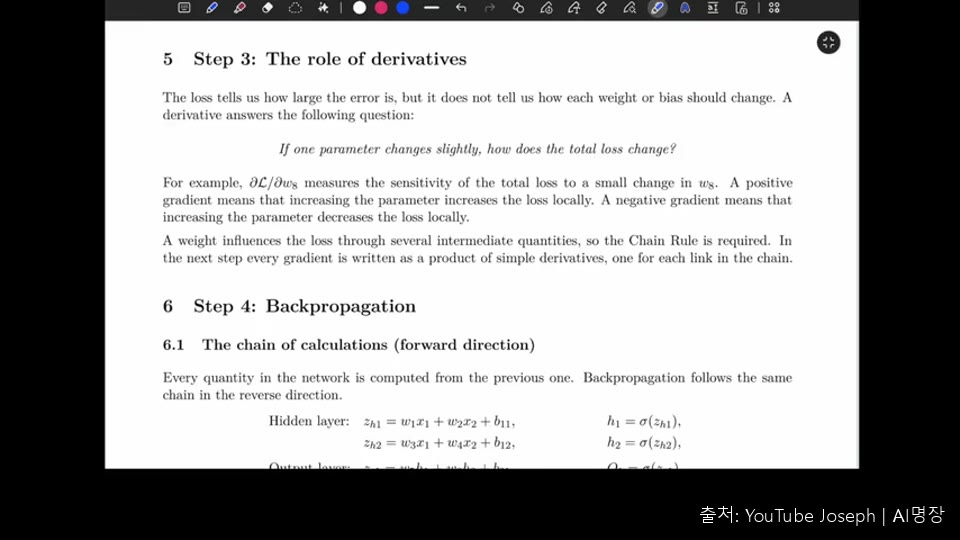
기울기가 양수이면 해당 값을 줄여야 손실이 줄고, 음수이면 늘려야 합니다. 값의 크기는 그 파라미터가 지금 손실에 얼마나 큰 영향을 주는지를 나타냅니다.
⏱ 12:126. 연쇄법칙과 역방향 계산
⏱ 12:12W5 같은 가중치는 손실에 직접 연결되지 않고 가중합, 시그모이드, 출력, 손실로 이어지는 연쇄적 영향을 줍니다. 이때 연쇄법칙을 써서 각 단계의 미분을 곱해 전체 기울기를 구합니다. 예를 들어 Y가 X의 3배 빠르게 변하고 Z가 Y의 2배 빠르게 변하면 Z는 X의 6배 빠르게 변한다는 식입니다.
⏱ 15:177. 시그모이드 미분과 가중합 미분
⏱ 15:17시그모이드의 미분은 시그모이드 값 곱하기 (1 - 시그모이드 값)으로 간단히 표현됩니다. 이미 계산된 출력값을 그대로 대입하면 되므로 계산이 편리하다는 점이 강조되고, 강사는 이를 직접 유도하는 과정도 보여 줍니다.
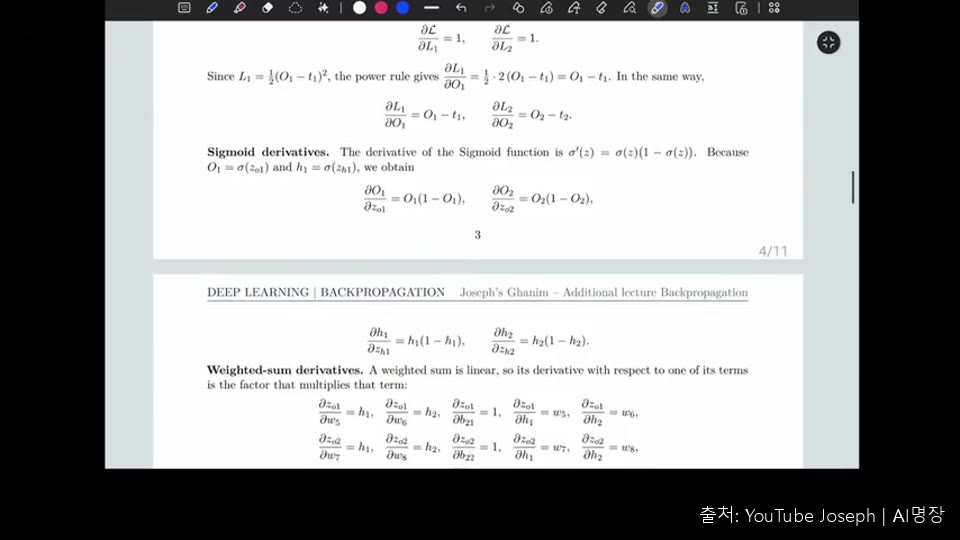
가중합의 미분은 곱해지는 항이 그대로 남습니다. 예를 들어 W5에 대한 미분은 H1이고, 편향의 미분은 1입니다. 입력이 0이면 해당 가중치는 출력에 영향을 주지 않으므로 학습 신호도 거의 없습니다. 출력층의 가중치는 손실까지 가는 경로가 하나뿐이어서 가장 단순한 경우입니다.