요약
⏱ 00:001. 점수만으로 게임 AI를 가르칠 수 있을까
⏱ 00:00게임 속 동료와 상대는 AI가 움직이는데, 발표자는 축구 게임 선수 22명을 규칙으로 직접 짰다고 소개합니다. 이번에는 규칙 대신 점수만 주고 스스로 배우게 하면 어떻게 되는지 실험해 봅니다.
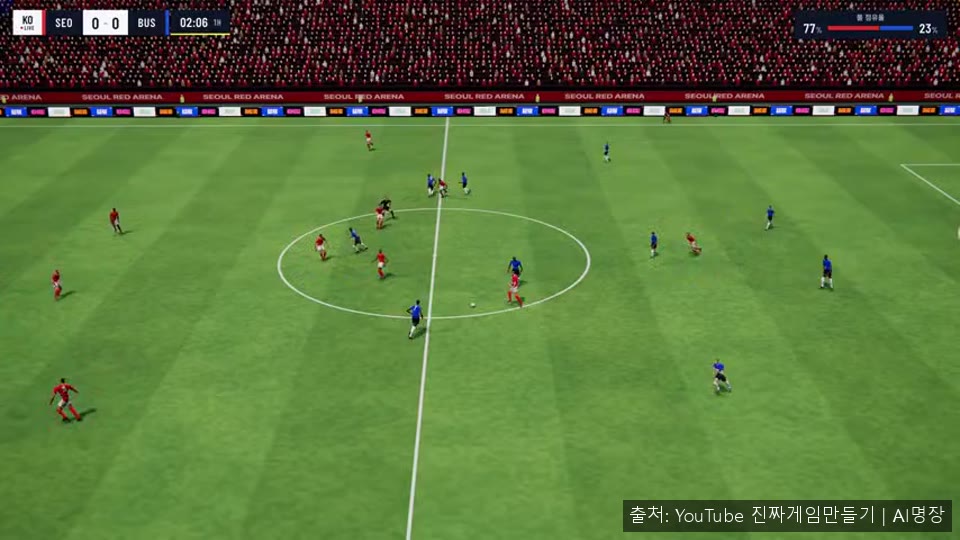
연습장은 칸으로 나눈 작은 경기장이고, 처음에는 선수가 공 근처에도 가지 못한 채 아무렇게나 뛰어다녔습니다. 점수 설정을 한 줄 잘못 주자 골은 넣지 않고 공만 만지작거리는 행동도 나왔습니다.
⏱ 00:302. 학습 방법 세 가지
⏱ 00:30AI 학습법은 지도학습, 비지도학습, 강화학습 세 가지로 나뉩니다. 셋 모두 데이터를 보고 판단 기준을 스스로 만든다는 점은 같지만, 무엇을 기준으로 주느냐가 다릅니다.
⏱ 01:133. 지도학습: 정답이 붙은 킥 기록
⏱ 01:13선수가 공을 찰 때마다 위치와 함께 슛인지 패스인지를 기록해 정답을 붙인 데이터를 라벨 데이터라고 합니다. 60경기에서 6천 번이 넘는 킥을 모았는데 슛은 214번뿐이라 패스가 훨씬 많았습니다.
학습용과 시험용 기록을 나눠 평가했고, 슛과 패스 수를 비슷하게 맞춘 새 킥 107개로 시험했을 때 약 97%를 맞혔습니다. 다만 정답을 따라 하는 방식이라 정답 기록보다 잘할 수는 없다는 한계가 있습니다.
⏱ 02:044. 비지도학습: 정답 없이 포지션 묶기
⏱ 02:04정답 없이 선수들의 평균 위치만 주고 비슷한 것끼리 묶어 보게 했습니다. 묶음 개수는 사람이 정해야 해서 네 개로 설정했고, 골키퍼는 한 명도 틀리지 않고 따로 묶였습니다.

그런데 포지션이 섞인 묶음이 하나 나왔고, 알고 보니 오른쪽 라인에 서는 선수들이었습니다. 앞뒤 거리만 기준으로 주자 수비, 미드필더, 공격으로 나뉘었습니다. 무엇을 기준으로 볼지와 묶음에 이름을 붙이는 일은 여전히 사람의 몫이라는 점을 보여 줍니다.
⏱ 02:445. 강화학습 연습장 설계
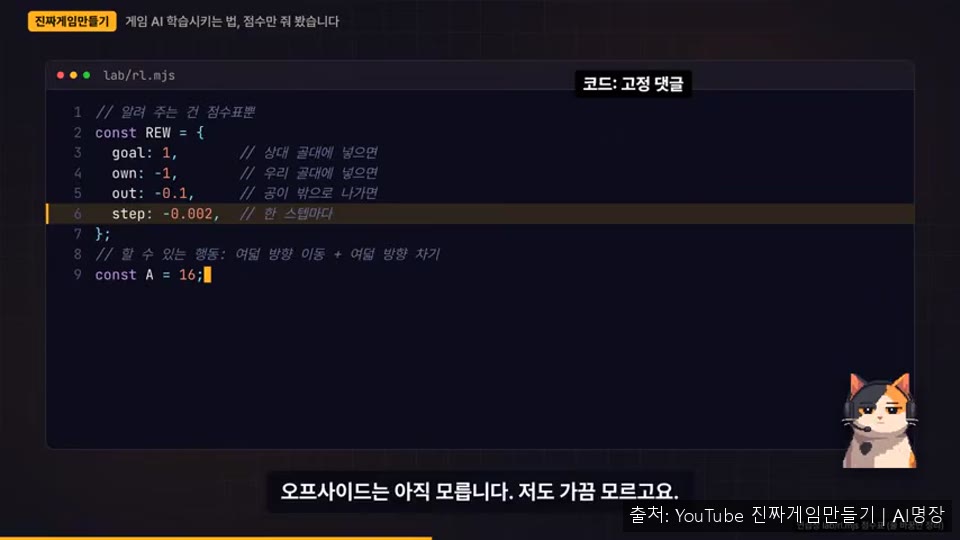
⏱ 02:44강화학습은 지금 상황, 할 수 있는 행동, 점수표 세 가지만 정하면 됩니다. 실제 게임의 물리 계산을 붙여 수백만 판을 돌리기는 무거워서, 경기장을 칸으로 나눈 연습장에 선수 하나와 골키퍼 하나를 세웠습니다.
상황은 내 칸과 공의 위치이고, 행동은 여덟 방향 이동과 여덟 방향 차기입니다. 점수표는 골이면 더하고 자책골과 밖으로 나간 공은 뺍니다. 처음에는 아무렇게나 움직이는 탐험 단계를 거쳐 무엇이 점수가 되는지 알아내고, 연습이 쌓일수록 무작위 행동의 비율을 줄여 갑니다.
⏱ 03:176. 보상이 드문 문제와 학습 과정
⏱ 03:171만 판을 연습해도 시험 300판에서 골이 2번뿐이었습니다. 점수를 한 번도 받지 못하면 어떤 행동이 좋았는지 알 수 없는데, 이런 상황을 보상이 드물다고 부릅니다.
5만 판쯤 지나 우연히 골이 나오자 그 직전 행동들의 점수가 골대 앞 칸부터 거꾸로 번졌습니다. 20만 판째에는 공을 몰고 상대 골대 쪽인 오른쪽으로 가기 시작했지만 골대 앞 마무리는 서툴렀습니다. 성적은 50만 판까지 거의 바닥이다가 100만 판 근처에서 크게 올랐고, 나중에는 골키퍼가 따라오면 반대쪽으로 차는 법도 익혔습니다. 시험 300판에서는 199골을 넣었고 자책골은 없었습니다.
⏱ 04:447. 보상 해킹과 학습법 고르기
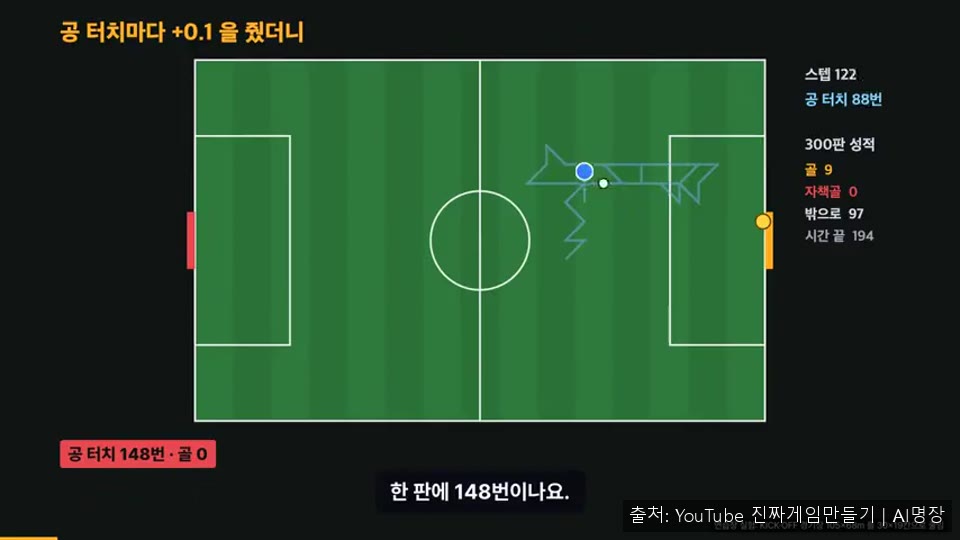
⏱ 04:44공을 만질 때마다 0.1점을 더 주자, 골을 넣으면 판이 끝나 추가 점수를 받을 수 없으니 골 대신 공을 계속 만지작거리는 판이 나왔습니다. 점수는 챙기고 목적은 놓치는 이런 현상을 보상 해킹이라고 하며, 터치 점수를 빼자 다시 골 위주의 행동으로 돌아왔습니다.