
요약
⏱ 00:121. 세션 안내와 실습 준비
⏱ 00:12강사는 이번 세션이 Google Colab에서 코드를 함께 입력하며 따라가는 실습 중심이라고 안내한다. 영상만 보지 말고 직접 코드를 치고 변경도 시도해 보라고 권한다. 1주차부터 이어지는 흐름에 맞춰 진행한다는 점도 함께 짚는다.
⏱ 02:052. 세그멘테이션과 픽셀 단위 분류
⏱ 02:05수강생의 질문에 답하며 강사는 이미지 세그멘테이션을 픽셀 단위 분류로 볼 수 있다고 설명한다. 고양이의 경계를 그린다는 것은 각 픽셀이 고양이에 속하는지 판단한다는 뜻이며, 고양이 픽셀은 1, 나머지는 0으로 예측하면 이진 세그멘테이션이 된다.
이 결과를 흑백 이미지로 나타낸 것이 마스크다. 분류가 이미지 전체에 고양이가 있는지만 판단한다면, 세그멘테이션은 각 픽셀이 어디에 속하는지까지 예측한다는 점에서 차이가 있다.
⏱ 06:173. 라이브러리 임포트와 전처리 개념
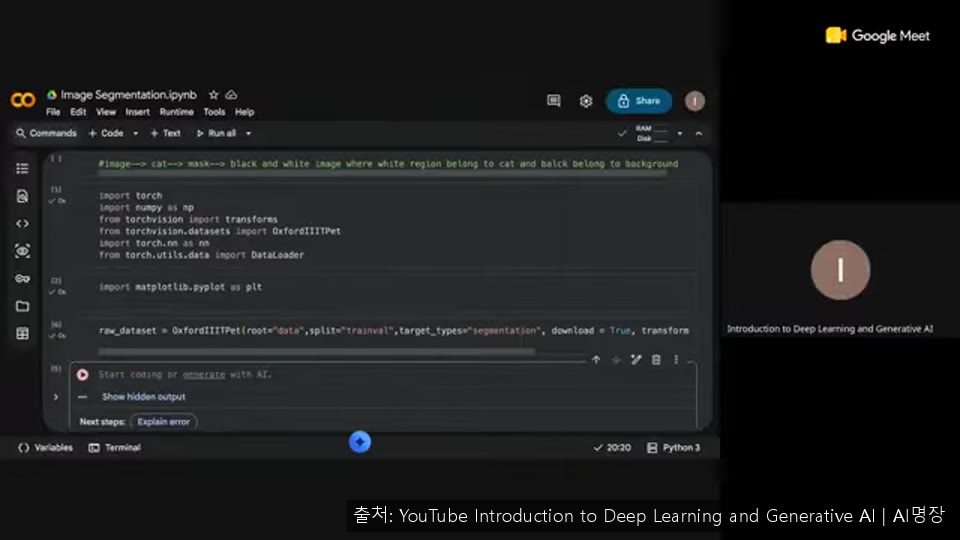
⏱ 06:17torch, torchvision, nn, DataLoader, matplotlib 등 기본 라이브러리를 불러오는 단계다. 강사는 이 중 transforms가 리사이즈, 텐서 변환, 정규화 같은 전처리를 한곳에 정의해 데이터 로딩 시 넘기는 도구라고 설명한다.

필요한 라이브러리는 실습이 진행되면서 그때그때 추가하기로 했다.
⏱ 07:414. Oxford-IIIT Pet 데이터 내려받기
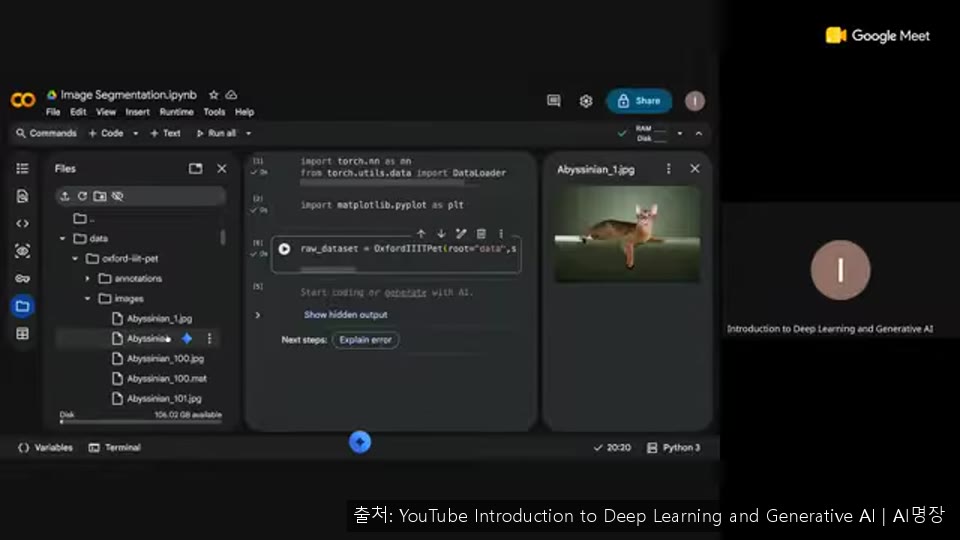
⏱ 07:41torchvision의 Oxford-IIIT Pet 데이터셋을 지정하고, 데이터를 저장할 root 폴더와 train split을 설정한다. target_types 옵션에 따라 분류용 category, 이진 category, 세그멘테이션용 trimap 등 목적에 맞는 라벨을 받을 수 있다.

이번 실습에서는 segmentation을 선택하고 transform은 아직 적용하지 않는다. 데이터 용량이 커서 로딩에 시간이 걸리며, 강사는 코드를 메일이나 채팅으로 공유했다.
⏱ 09:185. 데이터 구조 확인과 샘플 열어보기
⏱ 09:18데이터는 이미지와 그에 대응하는 어노테이션(마스크) 쌍으로 구성된다. 첫 번째 샘플을 불러와 고양이 이미지를 확인하고, 어노테이션 안에 들어 있는 마스크 정보를 살펴본다.

실행 과정에서 오류가 발생해 강사가 다른 방식으로 다시 시도했다. 데이터를 직접 눈으로 확인하는 것이 이후 단계를 이해하는 데 중요하다는 점을 강조한다.
⏱ 16:456. 마스크 해석과 시각화
⏱ 16:45마스크에서는 대상 객체가 있는 픽셀에만 값이 부여된다. 이진 마스크라면 고양이 영역은 흰색, 나머지는 검은색으로 보이며, 픽셀 값이 0과 1 두 가지인 경우가 가장 단순한 형태다.
이렇게 만든 이미지와 마스크 쌍이 세그멘테이션 모델의 학습 데이터가 된다. 강사는 이 구조를 먼저 이해해야 다음 단계의 모델 설계가 쉬워진다고 본다.
⏱ 18:077. 리사이즈와 텐서 변환 준비
⏱ 18:07원본 이미지 크기가 제각각일 수 있으므로 128이나 256 같은 균일한 크기로 리사이즈해야 배치 처리 중 오류를 막을 수 있다. 크기 선택은 실습자의 판단에 맡긴다.
이후 이미지를 텐서로 바꾸고 DataLoader로 배치 단위 처리를 준비한다. 다음 단계에서는 세그멘테이션 모델의 구조를 정의할 예정이다.


