요약
⏱ 00:001. 강화 학습의 문제와 지형 비유
⏱ 00:00강화 학습 에이전트는 선택지가 매우 많은 미로에서 모든 경로를 계산하지 않고도 좋은 정책을 찾아낸다. 그 비결은 미래 전체를 평가하지 않아도 되도록 해 주는 벨만 방정식에 있다.
발표는 문제 전체를 하나의 지형으로 그려 보라고 제안한다. 각 상황은 지점이고, 높이는 그곳에서 얻을 장기적인 보상을 뜻한다. 정점은 큰 미래 잠재력, 골짜기는 막다른 길을 의미하며 에이전트는 더 높은 곳을 향해 한 걸음씩 이동한다.
⏱ 01:172. 상태와 마르코프 성질
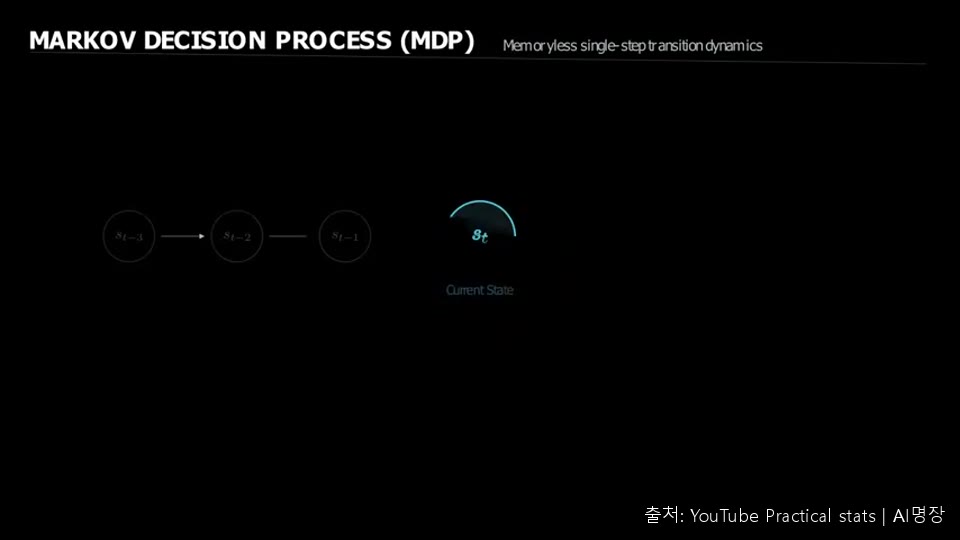
마르코프 성질은 미래가 과거의 이력이 아니라 현재 상태와 선택한 행동에만 의존한다는 규칙이다. 따라서 긴 사건의 연쇄도 단일 단계 전환들로 나누어 생각할 수 있다. 문제는 그 단계들을 모은 전체 여정을 어떻게 평가하느냐이다.
⏱ 02:213. 할인율과 보상의 합산
⏱ 02:21출퇴근길 예시에서 고속도로는 처음에는 빠르지만 나중에 정체가 생기고, 이면 도로는 처음에는 느리지만 나중에 넓게 뚫린다. 첫 단계만 보면 고속도로가 유리해 보이지만, 미래 가치를 할인해 합산하면 이면 도로의 가치가 더 높게 나온다.
미래 보상을 할인하는 이유는 할인 없이 무한한 과업의 보상을 더하면 합이 발산할 수 있기 때문이다. 감마는 0 이상 1 미만의 값으로, 뒤 단계일수록 가치를 조금씩 낮추어 합이 유한하게 유지되도록 한다. 감마가 0에 가까우면 근시안적이고, 1에 가까우면 먼 미래를 본다.
⏱ 02:574. 벨만 방정식과 행동 가치
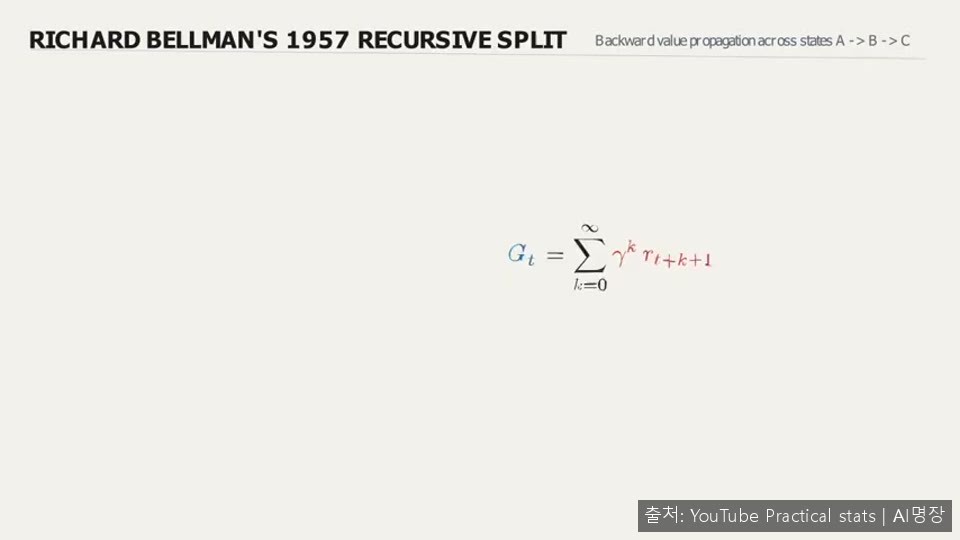
⏱ 02:571957년 리처드 벨만은 무한한 합을 두 부분으로 나눴다. 하나는 현재 단계에서 즉시 받는 보상이고, 다른 하나는 다음 상태의 할인된 가치다. 이 덕분에 전체 경로를 추적하지 않아도 가치가 뒤쪽 상태에서 앞쪽으로 한 단계씩 전달된다.
⏱ 05:115. 모델이 있을 때의 계획법
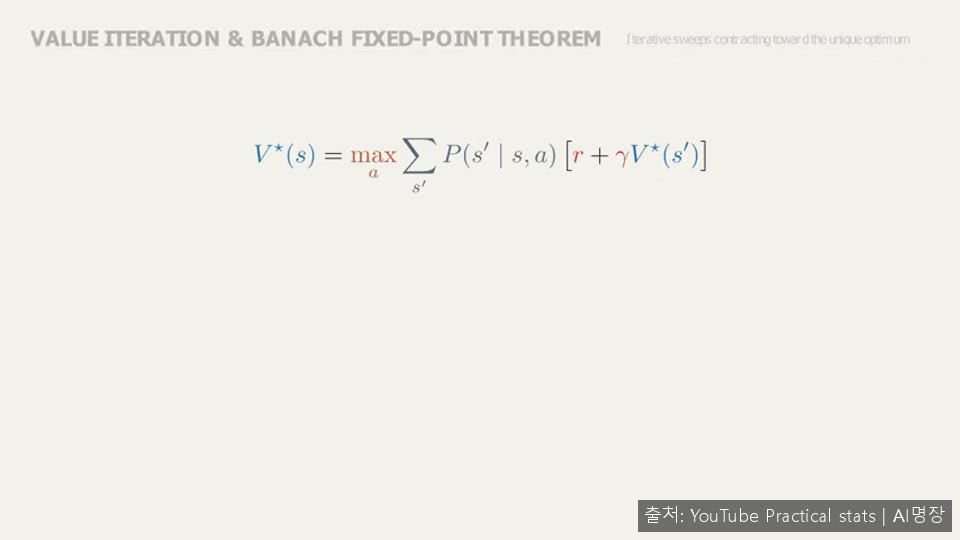
⏱ 05:11환경의 전이 확률과 보상 함수를 모두 안다면 문제는 계획 문제가 된다. 가치 반복법은 모든 상태의 가치를 0에서 시작해 이웃의 현재 추정치로 반복 갱신한다. 감마가 1보다 작으면 벨만 연산자가 축소 사상이 되어 유일한 최적 가치 함수로 수렴한다.
⏱ 06:316. 심층 Q-네트워크와 시간차 오차
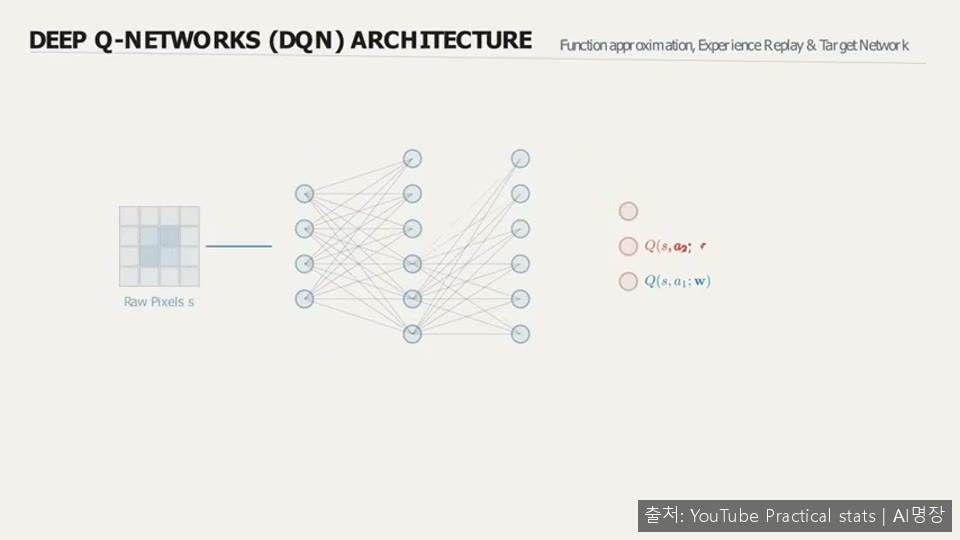
⏱ 06:31상태 공간이 원본 픽셀처럼 폭발적으로 커지면 상태별 표를 저장할 수 없다. 심층 Q-네트워크는 이 표를 신경망으로 대체해 상태를 입력받아 모든 행동의 Q값을 추정한다. 학습을 안정시키기 위해 과거 경험을 무작위로 뽑는 경험 재생과, 타겟을 고정하는 별도의 타겟 네트워크를 함께 쓴다.