요약
⏱ 00:001. AI는 강력한 도구라는 출발점
⏱ 00:00강의는 인공지능이 데이터에서 패턴을 찾아 새로운 문제에 적용하는 강력한 도구라는 점에서 출발합니다. 공상과학에서 흔히 그리는 것처럼 AI가 감정을 가지고 인간에게 반항한다는 이야기는 현재 배운 방식의 AI와 맞지 않으며, 실제 위험은 기계의 반란이 아니라 사람이 AI를 잘못 만들거나 잘못 쓰는 데 있다고 설명합니다.

이 오용을 막기 위해 Microsoft가 제시한 책임 있는 AI의 여섯 원칙을 하나씩 살펴보겠다고 예고합니다. 프로그래밍 지식이 없어도 따라갈 수 있다는 점도 강조합니다.
⏱ 02:012. 공정성과 모델 편향
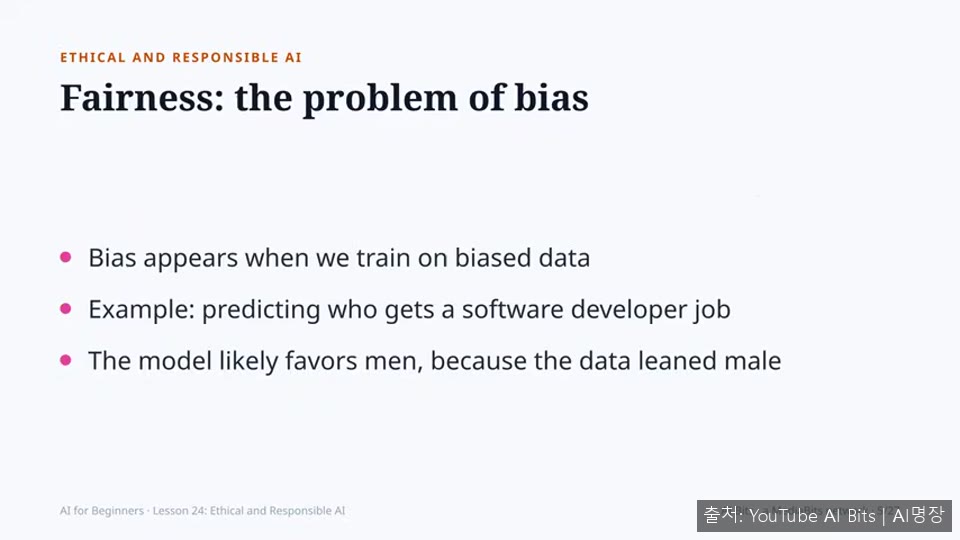
⏱ 02:01공정성은 편향된 학습 데이터에서 비롯되는 모델 편향 문제를 다룹니다. 예시로 소프트웨어 개발자 채용 확률을 예측하는 모델을 들었는데, 학습 데이터가 남성 중심으로 치우쳐 있으면 모델은 남성을 더 높게 평가하게 됩니다. 남성이 실제로 더 뛰어나서가 아니라 모델이 데이터에 있던 내용을 그대로 배운 결과라는 뜻입니다.
⏱ 02:533. 신뢰성과 안전성
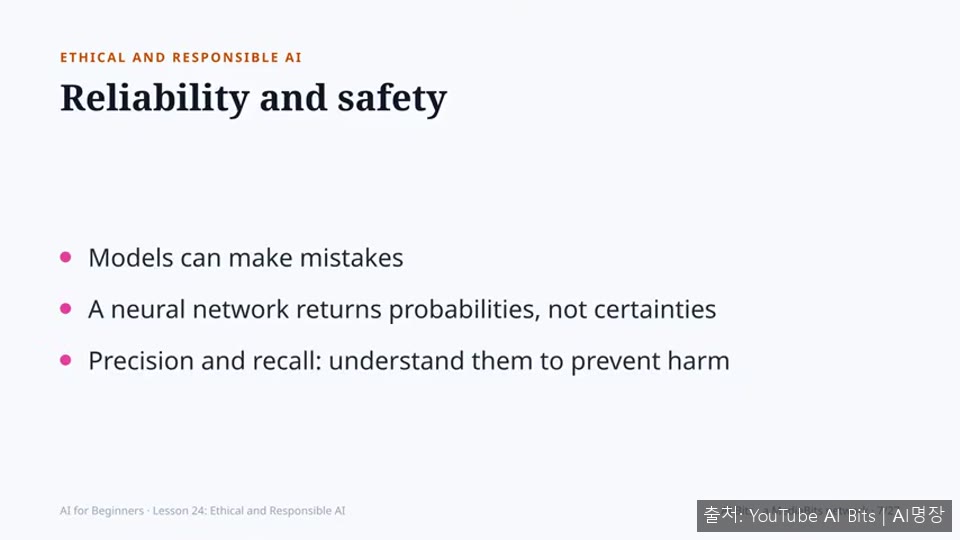
⏱ 02:53신뢰성과 안전성은 AI 모델이 본질적으로 실수할 수 있다는 점에서 출발합니다. 신경망은 확실한 답이 아니라 확률을 내놓으므로, 사람이 판단할 때 이 불확실성을 고려해야 합니다.

또한 모든 모델에는 정밀도(precision)와 재현율(recall)이 있으며, 정밀도는 긍정이라고 답한 것 중 맞은 비율, 재현율은 실제 해당되는 사례 중 찾아낸 비율이라고 쉽게 설명합니다. 잘못된 조언이 낳는 피해를 막으려면 두 지표를 모두 이해해야 한다고 강조합니다.
⏱ 03:264. 개인정보 보호와 포용성
⏱ 03:26개인정보 보호와 보안 원칙은 학습에 쓴 데이터가 모델 안에 어느 정도 녹아든다는 점을 짚습니다. 데이터는 보안과 개인정보 보호를 높이는 방향으로 작용하지만, 모델이 어떤 데이터로 학습했는지 기억하고, 학습 전에 어떤 데이터를 쓰는지, 그 안에 누가 포함되는지 물어야 한다고 말합니다.
⏱ 04:155. 투명성과 책임성
⏱ 04:15투명성은 먼저 AI를 사용하고 있다는 사실을 분명히 밝히고, 가능하면 결정 과정을 이해할 수 있는 해석 가능한 시스템을 쓰라는 원칙입니다. 사람이 읽을 수 있는 규칙으로 판단하는 전문가 시스템이 대표적인 예이며, 신경망이나 이미지 분류기는 해석이 더 어렵다고 설명합니다. 내부가 보이는 유리 상자와 닫힌 상자의 차이로 비유합니다.

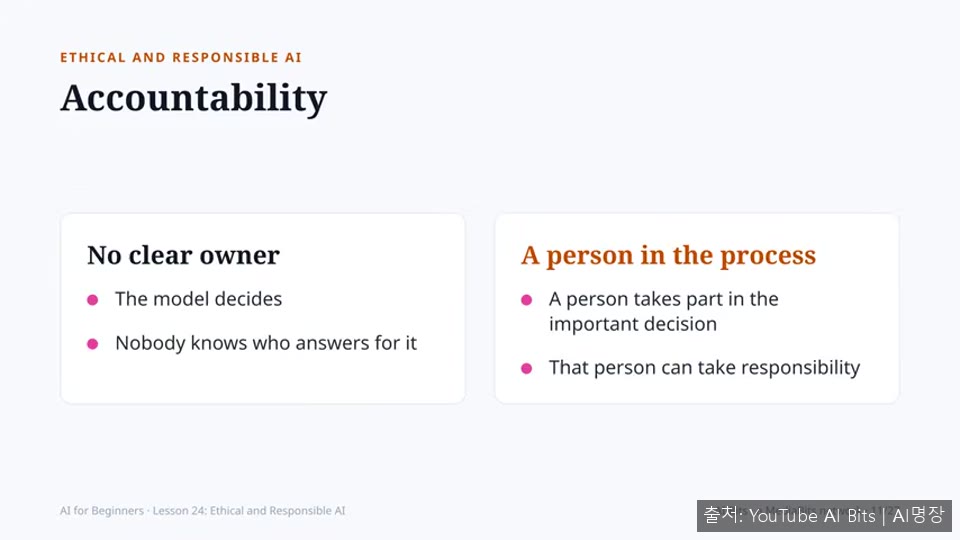
책임성은 모델이 내린 결정에 대해 누가 책임지는지 분명히 해야 한다는 원칙입니다. 중요한 결정에는 사람을 판단 과정에 포함시켜, 실제 사람이 결정에 관여하고 그 결정에 책임질 수 있도록 해야 한다고 정리합니다.
⏱ 05:116. 실천을 위한 도구 소개
⏱ 05:11원칙을 실천하기 위해 Microsoft가 만든 Responsible AI Toolbox의 도구들을 소개합니다. 해석 가능성 대시보드인 InterpretML, 공정성 대시보드인 FairLearn, 오류 분석 대시보드가 있고, 여기에 인과 분석을 다루는 EconML과 반사실적 분석을 다루는 DiCE를 포함한 Responsible AI 대시보드가 있다고 이름만 짚습니다. 자세한 링크는 영상 설명란에 있다고 안내합니다.
⏱ 05:507. 퀴즈 복습과 마무리 과제
⏱ 05:50공식 퀴즈 문항을 복습합니다. AI는 강력한 도구라서 해를 끼칠 수 있고 사람을 차별하지 않도록 해야 한다는 점, 해석 가능한 AI의 예로 전문가 시스템을 드는 이유, 차별의 주된 원인은 데이터 불균형이라는 점, 여섯 원칙에 포함되지 않는 것은 cleverness라는 점, 책임성은 책임질 수 있는 사람이 판단에 관여하는 것이라는 점을 확인합니다. 모델 공정성은 편향과 관련된다는 문항도 다룹니다.

마지막으로 매일 쓰는 AI 응용을 하나 골라 원칙별 질문 여섯 가지를 던져 보라는 과제를 제시하며 24강 전체 과정을 마무리합니다.